读文献6-Change3D/UniChange
本文最后更新于 2026年11月10日 晚上
Change3D
论文名称:Change3D: Revisiting Change Detection and Captioning from A Video Modeling Perspective
阅读日期:2026.11.5
所属方向与编号:视觉语言驱动的变化检测-05
1. 这篇论文要解决什么问题?
变化检测和变化描述是遥感领域的核心任务,通过分析同一地区不同时间的一对图像,识别地表变化(如建筑损毁评估、城市规划、环境监测)。现有主流方法遵循固定范式:用共享权重的图像编码器分别提取两张图的空间特征,再通过专门设计的”变化提取器”(基于交叉注意力等机制)捕捉差异,最后用解码器输出结果。这类基于CNN、Transformer或混合架构的2D模型已取得显著成功。
- 图像编码是任务无关的过程,无法在编码阶段关注变化区域,且导致参数分布失衡:绝大部分参数花在与任务无关的图像编码上,用于变化提取的参数极少
- 不同任务(二值变化检测、语义变化检测、建筑损毁评估、变化描述)需要各自设计不同的变化提取器,难以形成统一框架
本文提出Change3D,将双时相图像视为仅含两帧的微型视频,在图像间插入可学习的”感知帧”,用视频编码器直接感知差异,从而摆脱复杂的变化提取器
2. 输入和输出,整体流程分别是什么?
1 | |
输入:一对双时相遥感图像 $I_1, I_2 \in R^{H \times W \times 3}$ + $K$ 个可学习的感知帧 $I_P = {I_P^1, …, I_P^K}$(每个感知帧尺寸也是 $(H, W, 3)$)
输出(因任务而异,$K$ 的取值由任务决定):
- 二值变化检测(BCD, $K=1$) $\rightarrow$ 二值变化图 $M_{binary} \in {0,1}^{H \times W}$
- 语义变化检测(SCD, $K=3$) $\rightarrow$ 语义变化图 $M_{semantic} \in {0,…,N_{semantic}-1}^{H \times W}$
- 建筑损毁评估(BDA, $K=2$) $\rightarrow$ 建筑定位图 + 损毁分类图 $M_{damage}$
- 变化描述(CC, $K=1$) $\rightarrow$ 一句描述变化的自然语言文本 $W$
2.1 训练阶段
Step 1. 输入组装
从数据集取出双时相图像 $I_1$、$I_2$(训练统一裁剪为 $256 \times 256$)和随机初始化的感知帧 $I_P$,沿时间维拼接构造输入视频:
$$
f = \mathcal{F}_{enc}(I_1 \oplus I_P \oplus I_2)
$$
其中 $\oplus$ 表示时间维拼接,拼接后总帧数 $T = K + 2$(BCD 时输入为三帧张量 $(3, 3, 256, 256)$)。此时视频编码器加载 Kinetics-400 预训练权重,感知帧和解码器随机初始化。
Step 2. 编码器逐层提取特征
视频编码器输出三个层级的特征金字塔:
$$
f \in \{ \mathbb{R}^{T \times C_i \times \frac{H}{2^{i+1}} \times \frac{W}{2^{i+1}}} \}_{i=0}^3
$$
即每一层 $i$ 的特征形状为 $(T, C_i, H/2^{i+1}, W/2^{i+1})$,随层级加深分辨率减半、通道增加。其中 $f_i^t$ 表示第 $i$ 层第 $t$ 帧的特征——3D 卷积在时间维滑动,使感知帧从第一层起就与两侧真实图像帧交互。
Step 3. 选取感知特征
从每层特征中取出感知帧所在位置的帧特征作为检测用感知特征:
$$
p_{det}^{i,j} \in {f_i^1, \cdots, f_i^{T-2}}
$$
描述任务则取最深感知特征 $p_{cap} = f_3^1$
Step 4. 差分特征融合增强
用 1×1 卷积 + ReLU 将双时相帧 $f_i^0$ 与 $f_i^{T-1}$ 的差分信息整合进感知特征:
$$
\tilde{p} = \text{ReLU}(\text{Conv}_{1 \times 1}(f_i^0 - f_i^{T-1})) + p_{det}^{i,j}
$$
使感知特征同时携带时空编码的隐式差异与显式差分信息。
Step 5. 检测解码器逐层上采样(检测任务)
感知特征由深到浅逐层融合恢复分辨率:
$$
p_{det}^{i,j} \leftarrow \text{Deconv}_{4 \times 4}(\text{Conv}_{1 \times 1}(p_{det}^{i+1,j})) + p_{det}^{i,j}
$$
其中 $\text{Conv}_{1 \times 1}$ 为 1×1 二维卷积,$\text{Deconv}_{4 \times 4}$ 为核 4×4、步长 2×2 的转置卷积。经过逐层操作,特征从最深层(如 $32 \times 32$)逐步恢复到最浅层($128 \times 128$)。
Step 6. 生成变化图(检测任务)
对最浅层特征做分类并沿通道维取 argmax:
$$
\mathcal{M} = \arg \max (\text{Conv}_{3 \times 3} (p_{det}^{0,j}))
$$
输出 $M \in \{0,…,N-1\}^{H \times W}$,N 为地物类别数或损毁等级数。SCD 时三个感知特征分别经各自的检测解码器输出 $T_1$ 语义图、$T_2$ 语义图、二值变化图;BDA 时两个感知特征分别输出建筑定位图和损毁分类图。
Step 6’. 生成描述文本(描述任务)
词嵌入经自注意力和交叉注意力建模变化:
$$
e’_w = \text{CrossAttn}(\text{SelfAttn}(e_w), p_{cap}) + e_w
$$
其中 $e_w \in \mathbb{R}^{L \times D}$ 为词嵌入(含可学习位置编码),掩码操作防止后续词泄漏,$p_{cap}$ 作为 key/value。再经全连接层和 softmax 输出逐词概率分布:
$$
\mathcal{W} = \text{softmax}(\text{FC}(e’_w))
$$
Step 7. 计算联合损失并反向传播
四个任务的损失函数为:
$$
\mathcal{L}_{BCD} = \mathcal{L}_{ce} + \mathcal{L}_{dice}, \quad \mathcal{L}_{SCD} = \mathcal{L}_{ce} + \mathcal{L}_{dice} + \mathcal{L}_{sim}
$$
$$
\mathcal{L}_{BDA} = \mathcal{L}_{ce} + \mathcal{L}_{dice}, \quad \mathcal{L}_{CC} = \mathcal{L}_{ce}
$$
其中 $L_{ce}$ 为交叉熵损失,$L_{dice}$ 为 Dice 损失(缓解前景-背景不平衡),$L_{sim}$ 为余弦相似度损失。损失反传更新三部分参数:视频编码器、感知帧本身、解码器。
2.2 推理阶段
Step 1. 输入组装
输入一对双时相图像 $I_1$、$I_2$,与训练完成后已固化为模型权重的感知帧 $I_P$ 沿时间维拼接(与训练 Step 1 完全相同的操作),无需任何标签。
Step 2. 编码与前向传播
执行与训练相同的前向计算:
$$
f = \mathcal{F}_{enc}(I_1 \oplus I_P \oplus I_2)
$$
提取多层特征,选取感知特征并用 1×1 卷积 + ReLU 融合差分信息(训练 Step 2-4 的操作,仅前向、无梯度)。
Step 3. 解码输出最终结果
- 检测任务:执行逐层上采样融合后,直接输出:
$$
\mathcal{M} = \arg \max (\text{Conv}_{3 \times 3} (p_{det}^{0,j}))
$$
得到原图分辨率 $H \times W$ 的变化图(二值图 / 语义图 / 建筑定位图 + 损毁分类图),例如 LEVIR-CD 上输出 F1 = 91.82 的二值变化图,xBD 上输出建筑定位图和四级损毁分类图。
- 描述任务:softmax 逐词概率经自回归解码生成描述文本,如 “Many villas are built on the bareland at the bottom right of the area.”。
Step 4. 性能评估
变化检测结果用 F1、IoU、OA、SeK 评估;描述结果用 BLEU-N ($N=1,2,3,4$)、METEOR、ROUGE-L、CIDEr 评估。推理速度为最快水平( LEVIR-CD 上 0.015 s/sample,LEVIR-CC 上 0.007 s/sample)
3. 实验部分
使用的数据集
- LEVIR-CD
- WHU-CD
- CLCD
- HRSCD
- SECOND
- xBD
- LEVIR-CC
- DUBAI-CC
1-3为而知变化检测数据集,包括建筑物、道路和湖泊的变化
4-5为语义变化检测收集的,分别包括5个和6个土地覆盖类别,用于语义学习
6是一个建筑损坏评估数据集,提供四个损伤类别
7-8是变化描述数据集,提供每对图像的建筑物和城市化变化的详细描述,每张图像对有五句话
评价指标
- IoU—交并比
- OA—命中率
- SeK—
以上用于报告变化检测性能
- BLEU-N(N=1,2,3,4)
- METEOR
- ROUGE-L
- CIDEr
评估变化描述性能
实验细节
- I3D
- Slow-R50
- UniFormer-XS
- X2D-L
以上作为视频编码器来验证本实验的方法有效
首先在 Kinetics-400 上预训练,解码器 和 感知帧随机初始化
使用Adam 优化器,beta = (0.9,0.99) ,衰减权重设置为1e-4
初始lr=2e-4,并根据调度减少公式逐渐降低:$(1-(curr\_iter/max\_iter))^\alpha \times lr$,其中 $\alpha = 0.9$
xBD 数据集的最大迭代次数设置为200K,其余数据集为 80K。所有数据集的图像裁剪为 256×256 不重叠的块, HRSCD和SECOND的批大小为8,LEVIR‐CC和 DUBAI‐CC为32,其余为16。
4. 与前一篇相比,核心变化是什么?
本文主要给出了一种新的范式,这个解决思路提供了一种新的可能。将图片的变化转为视频帧的变化,进行检测
前几篇都是图与图之间的变化检测
UniChange
论文名称:UniChange: Unifying Change Detection with Multimodal Large Language Model
阅读日期:2026.11.10
所属方向与编号:视觉语言驱动的变化检测-06
SeK $\rightarrow$ 评价指标 $\rightarrow$ Separated Kappa coefficient(分离 Kappa 系数),专门为语义变化检测(SCD)设计的评测指标,由 SECOND 数据集的论文(Yang 等,Asymmetric Siamese Networks)首次提出,用于衡量模型在“变化区域”内区分不同语义类别的能力
SeK $\rightarrow$ 设计动机 $\rightarrow$ 解决传统指标在 SCD 上的“虚高”问题
为什么需要它?
在 SECOND 这类数据集里,“未变化(non-change)”像素占了绝大多数(可能 95% 以上),真正发生变化的像素是极少数。传统的总体精度(OA)和 Kappa 系数会把这海量的“未变化”像素也算进对角线一致项里——哪怕模型完全没识别出任何变化类别,只要把大部分区域都判为“未变化”,OA 依然很高。SeK 的做法就是把“未变化”类从计算中剥离出去,只考察模型在真正变化区域内的语义区分能力。
1. 这篇论文要解决什么问题?
变化检测(CD)是遥感领域的核心任务,分为二值变化检测(BCD,只找变化位置)和语义变化检测(SCD,还需识别“从什么变成什么”)两个子领域。长期以来,两个子领域各自发展出高度专业化、互不相通的模型架构(BCD 用单变化解码器,SCD 需要多解码器),且不同数据集间存在语义冲突——如“建筑”在一个数据集是正样本、在另一个数据集是背景——导致传统模型只能基于单一标注类型、单一数据集训练,泛化能力差、实用性受限。
提出 UniChange,首个基于多模态大语言模型(MLLM)的统一变化检测框架,目标是用一个端到端模型同时完成 BCD 和 SCD 两种任务,并实现多源数据集的联合训练。
2. 输入和输出、整体流程分别是什么?
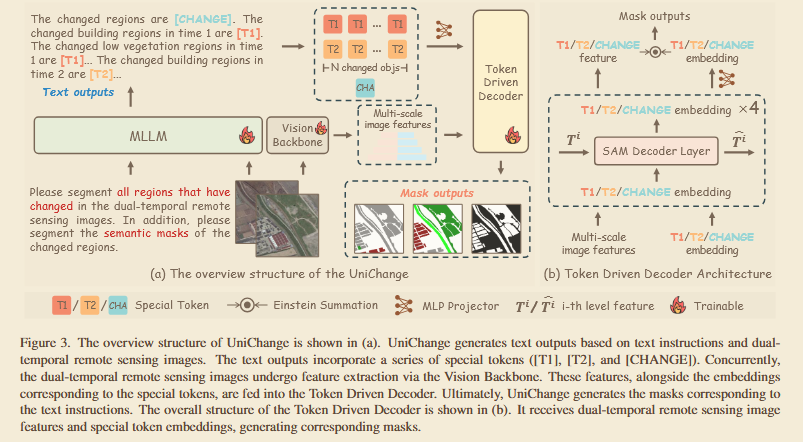
输入(公式 1):
- 双时相遥感影像对:$x_{img1}, x_{img2} \in \mathbb{R}^{H \times W \times C}$,即同一地区 T1(早期)和 T2(晚期)时刻的两张影像,其中 H、W、C 为高度、宽度、通道数;
- 文本指令 $x_{txt}$:一条变化查询,可以是二值查询(如 “Please segment all areas that have undergone change”),也可以是语义查询(如 “Please segment the semantic masks of the changed areas”)。
输出:
- 文本回复 $y_{txt}$:MLLM 生成的自然语言描述,其中嵌入特殊 token [T1]、[T2]、[CHANGE];
- 掩码集合 $\hat{M}$:与指令对应的像素级掩码(二值变化掩码和/或双时相语义掩码)。整体过程由公式 (1) 定义:
$$
\hat{M} = \Phi_{UniChange}(x_{img1}, x_{img2}, x_{txt}) \tag{1}
$$
其中 $\Phi_{UniChange}$ 表示整个统一变化检测模型。
2.1 训练阶段
Step 1. 原始数据组织
输入形态:
- 影像对:BCD 数据集为 $1024 \times 1024 \times 3$ 的双时相图像对(WHU-CD 由 $32507 \times 15354$ 大图裁剪成 $1024 \times 1024$ patch 并按 8:1:1 划分;LEVIR-CD+ 原生 $1024 \times 1024$,637 训练 / 348 测试);SECOND 为 $512 \times 512 \times 3$ 图像对(4662 对)。
- 文本指令:自然语言字符串,如 “Please segment all regions that have changed… please segment the semantic masks of the changed regions” 。
- 标签:变化掩码(BCD)或变化掩码 + 双时相语义掩码(SCD,SECOND 含 6 类:building、low vegetation、tree、water、playground、bare ground)。
数据变化:原始大图 $\rightarrow$ (裁剪/分块) $\rightarrow$ $[T1] \in \mathbb{R}^{1024 \times 1024 \times 3}$,$[T2] \in \mathbb{R}^{1024 \times 1024 \times 3}$ (SECOND 则为 $512 \times 512 \times 3$);文本 $\rightarrow$ (tokenizer 分词) $\rightarrow$ token 序列,长度记为 $L_{txt}$ (推断)。
Step 2. 视觉骨干提取多尺度特征
模块:RSBuilding-ViT-L(SAM 结构、遥感预训练权重),全参数微调。
数据变化:
- 每张时相影像 $\rightarrow$ (ViT-L 编码) $\rightarrow$ 基础密集视觉特征;
- 经 max-pooling(下采样)+ 转置卷积(上采样)构建四层特征金字塔,对应 $i = 1, 2, 3, 4$(推断典型尺寸为 $256 \times 32 \times 32$、$256 \times 64 \times 64$、$256 \times 128 \times 128$、$256 \times 256 \times 256$,即通道 256、分辨率逐级翻倍);
- 输出两组多尺度特征集:
$$
{F_1^i}, {F_2^i} = F_{enc}(x_{img1}, x_{img2}) \tag{4-1}
$$
- 最后,这些双时相视觉特征连同投影任务嵌入$\hat{h}_{task}$,被送入由 token 驱动的解码器 $ \mathcal{F}_{dec}$中,以生成最终掩码 $\hat{M}_{task}$,整个流程参考公式
(4-1) -----> (4-2)$$
\hat{M}_{task} = \mathcal{F}_{dec}({F_1^i}, {F_2^i}, \hat{h}_{task})\tag{4-2}
$$
Step 3. MLLM 生成含特殊 token 的回复
模块:LLaVA-7B-v1-1,仅语言解码器做 LoRA 微调(rank=8,alpha=16,即两倍 rank)。
数据变化:
- 影像经 LLaVA 的视觉编码器转成视觉 token 序列,与文本 token 拼接后进入 7B 语言模型
- 语言解码器自回归生成回复序列(公式 2):
$$
y_{txt} = F_{MLLM}(x_{img1}, x_{img2}, x_{txt})\tag{2}
$$
- 回复内容形如:“The changed regions are [CHANGE]. The changed building regions in time 1 are [T1]. The changed low vegetation regions in time 1 are [T1]… The changed building regions in time 2 are [T2]…”
- 序列长度 $L_{txt}$ 随变化的语义类别数动态增长——SCD 任务生成更多 [T1]/[T2] token(每个“from-to”转换各一个),BCD 任务通常只生成一个 [CHANGE] token。
Step 4. 提取并投影任务嵌入
数据变化:
从 $y_{txt}$ 最后一层隐状态中,定位每个特殊 token 位置,取出对应嵌入 $h_{task} \in \mathbb{R}^{d_{lim}}$(推断 $d_{lim} = 4096$)
经专用 MLP 层投影,对齐到下游视觉模块特征空间(公式 3):
$$
\hat{h}_{task} = MLP(h_{task}), \quad \hat{h}_{task} \in \mathbb{R}^{256} \text{(推断)} \tag{3}
$$
- 若序列中有 N 个特殊 token(如 SCD 任务),则得到 N 个 256 维稀疏嵌入,作为动态、指令引导的查询
Step 5. Token 驱动解码器:查询与特征逐层精炼
(a) 初始化查询(公式 5):
$$
E^0 = \Phi_{Cat}(\hat{h}_{t1}, \hat{h}_{t2}, \hat{h}_{change}) \in \mathbb{R}^{N \times 256} \text{(推断)}\tag{5}
$$N 为本样本中特殊 token 总数;Figure 3(b) (上图)显示该嵌入会复制 $\times 4$,供四层解码器逐层使用。
(b) 第 i 层解码器构建视觉序列(公式 6):
$$
T^i = \Phi_{Cat}(\Phi_{Flat}(F_1^i), \Phi_{Flat}(F_2^i))\tag{6}
$$数据变化:$F_1^i, F_2^i$ (各 $256 \times H_i \times W_i$) $\rightarrow$ (展平) $\rightarrow$ 各$H_iW_i \times 256$ 的 token 序列 $\rightarrow$ (拼接) $\rightarrow$ $T^i \in \mathbb{R}^{2H_iW_i \times 256}$ (推断)
(c) SAM 解码器层交互精炼(公式 7):
$$
E^i = \mathcal{F}_{FFN}(\mathcal{A}_{cross}(\mathcal{A}_{self}(E^{i-1}), T^i)), \quad \hat{T}^i = \mathcal{A}_{cross}(T^i, E^i)\tag{7}
$$数据变化:查询 $E^{i-1} \in \mathbb{R}^{N \times 256}$ 先自注意、再对 $T^i$ 交叉注意、过 FFN,得到 $E^i$(形状不变)
视觉序列 $T^i$ 再反向交叉注意更新为 $\hat{T}^i \in \mathbb{R}^{2H_iW_i \times 256}$ (推断)。所有注意力操作中查询与键均加入位置编码。此过程在 4 层中逐级进行,分辨率逐层提高
(d) 还原特征图(公式 8):
$$
{\hat{F}_1^i}, {\hat{F}_2^i} = \Phi_{Split/Reshape}({\hat{T}^i})\tag{8}
$$数据变化:$\hat{T}^i \rightarrow$ (切分 + 重塑) $\rightarrow$ 双时相二维特征图 $\hat{F}_1^i, \hat{F}_2^i \in \mathbb{R}^{256 \times H_i \times W_i}$ (推断)
(e) 构建三组融合特征(公式 9):
$$
F_{t1} = \Phi_{fuse}(\Phi_{Cat}({\Phi_{Up}(\hat{F}_1^i)})), \quad F_{t2} = \dots, \quad F_{change} = \Phi_{fuse}(\Phi_{Cat}({\Phi_{Up}(\hat{F}_1^i - \hat{F}_2^i)}))\tag{9}
$$数据变化:四层 $\hat{F}^i \rightarrow$ (上采样至统一分辨率) $\rightarrow$ (通道维拼接) $\rightarrow$ (融合卷积) $\rightarrow$ 得到 $F_{t1}, F_{t2}, F_{change}$_
其中 $F_{change}$ 特征源自双时相逐元素差值 $\hat{F}_1^i - \hat{F}_2^i$——这是变化检测专有的信号来源
(f) 最终掩码生成(公式 10、11):
$$
\hat{e}_{t1}, \hat{e}_{t2}, \hat{e}_{change} = \Phi_{Split/Proj}(E^4)\tag{10}
$$$$
\hat{M}_{task} = \mathcal{M}_{gen}(F_{task}, \hat{e}_{task}), ; task \in {t1, t2, change}\tag{11}
$$数据变化:最终查询 $E^4 \in \mathbb{R}^{N \times 256} \rightarrow$ (切分 + 投影) $\rightarrow$ 独立任务嵌入 $\hat{e}_{task}$
每组特征与对应嵌入做 Einstein Summation(爱因斯坦求和) $\rightarrow$ 输出单通道掩码 $\hat{M}_{task} \in \mathbb{R}^{1 \times H \times W}$ (BCD 样本通常只有 $\hat{M}_{change}$ 有监督;SCD 样本三个掩码均有监督)
Step 6. 损失计算与参数更新
文本损失(论文明确):$\mathcal{L}_{txt}$ 是对 $y_{txt}$ token 序列的标准自回归交叉熵,优化 next-token 预测——这同时训练模型“什么时候该输出 [T1]/[T2]/[CHANGE]”的能力。
掩码损失(公式 13):
$$
\mathcal{L}_{mask} = 2.0 \cdot \mathcal{L}_{BCE} + 0.5 \cdot \mathcal{L}_{Dice} + 0.5 \cdot \mathcal{L}_{SS} + 1.0 \cdot \mathcal{L}_{SC}\tag{13}
$$
- $\mathcal{L}_{BCE}$、$\mathcal{L}_{Dice}$:逐像素对比 $\hat{M}_{change}$ 与真值变化掩码(所有数据集均计算)
- $\mathcal{L}_{SS}$:$\hat{M}_{t1}, \hat{M}_{t2}$ 与双时相语义真值的逐像素交叉熵
- $\mathcal{L}_{SC}$:基于二值真值掩码,计算双时相语义特征图的余弦嵌入距离——未变化区域拉近、变化区域推离
- 关键分支:BCD 数据集样本 $\mathcal{L}_{SS} = \mathcal{L}_{SC} = 0$,仅 SCD 数据集(SECOND)计算这两项——这使同一个 $\mathcal{L}_{total} = \mathcal{L}_{txt} + \mathcal{L}_{mask}$ (公式 12)能同时适配语义冲突的多源数据集。
参数更新:反向传播仅更新 LoRA 低秩矩阵(语言解码器内,rank=8)+ 视觉骨干 + MLP 投影层 + Token 驱动解码器
总参数量以 7B 基座为主但可训参数大幅受限。训练 10 epochs × 400 步,4×80G H100,AdamW ($lr = 5 \times 10^{-5}$),per-device batch=1 × 梯度累积 8(有效 batch=8),DeepSpeed 引擎
2.2 推理阶段
Step 1. 用户提供输入:给定一对双时相影像(论文中以 <image_t1>、<image_t2> 标记)和一条自然语言指令,例如:“请分割双时相影像中变化的建筑物区域,另外请分割影像中所有建筑物”。
Step 2. MLLM 生成文本回复:按公式 (2),模型自回归生成如 “The changed building regions are [CHANGE]. The buildings in the time 1 image are [T1]. The buildings in the time 2 image are [T2].” 的回复。
Step 3. 提取 token 嵌入并投影:按公式 (3),从生成文本中定位特殊 token 位置,提取嵌入 $h_{task}$ 并经 $MLP(\cdot)$ 投影为视觉空间查询 $\hat{h}_{task}$。
Step 4. 视觉骨干提取特征:按公式 (4) 第一式,双时相影像经 $\mathcal{F}_{enc}$ 编码生成四层双时相特征金字塔。
Step 5. Token 驱动解码器输出掩码:按公式 (5)–(11) 流程,查询与特征逐层交互精炼,构建差值特征,最终由 Einstein Summation 生成掩码——对 BCD 查询输出一张变化掩码,对 SCD 查询输出变化掩码 + T1 语义掩码 + T2 语义掩码。
Step 6. 返回结果:同时呈现文本回复和像素级掩码图
3. 实验细节
使用的数据集
WHU-CD
S2Looking
LEVIR-CD+
SECOND
1-3 为二值变化检测(BCD)数据集,均聚焦建筑物变化——WHU-CD 为 0.075m 超高分辨率大图(32507×15354),S2Looking 为 0.5-0.8m 侧视卫星乡村影像,LEVIR-CD+ 为 0.5m 近正射美国城市影像,用于二值变化学习
4 为语义变化检测(SCD)数据集,包含 6 个土地覆盖类别(building、low vegetation、tree、water、playground、bare ground),标注”from-to”语义转换,并含同类变化样本,用于语义变化学习
四个数据集全部联合训练(单个模型统一训练,而非分别训练)
评价指标
- Precision、Recall、F1、IoU —— 用于报告二值变化检测(BCD)性能,均基于 TP/FP/FN 像素统计(WHU-CD、S2Looking、LEVIR-CD+ 及 SECOND)
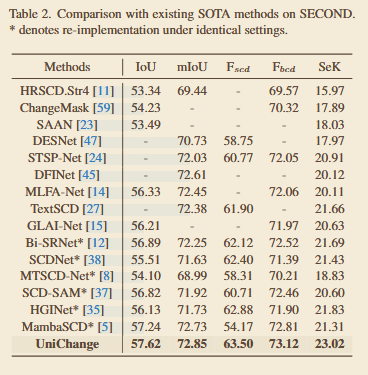
- mIoU、$F_{scd}$、SeK —— 用于报告语义变化检测(SCD)性能(SECOND);其中 SeK 削弱未变化类影响、$F_{scd}$ 专测变化区域内语义转换精度
- SECOND 上同时报告上述两套指标,做全面对比
实验细节
- LLaVA-7B-v1-1 —— 作为基座多模态大语言模型(MLLM),负责生成含 [T1]/[T2]/[CHANGE] 特殊 token 的文本回复
- RSBuilding-ViT-L —— 作为视觉骨干,SAM 结构、在遥感影像上预训练,全参数微调
- Token Driven Decoder —— 4 层 SAM Decoder Layer,接收 token 嵌入查询与四层多尺度双时相特征,输出掩码
- LoRA rank=8 (alpha=16) —— 仅语言解码器做低秩适配微调,其余组件全参数微调(混合微调策略)
- 损失权重 $\lambda_{BCE}=2.0$、$\lambda_{Dice}=0.5$、$\lambda_{SS}=0.5$、$\lambda_{SC}=1.0$ —— 掩码损失四项加权;在 BCD 数据集上 $L_{SS}$ 与 $L_{SC}$ 置零,仅 SECOND 上计算
- 10 epochs(每 epoch 400 步) —— 总训练量,4 块 NVIDIA 80G H100 GPU
- AdamW,学习率 $5 \times 10^{-5}$ —— 优化器配置;per-device batch=1 + 梯度累积 8(有效 batch=8),DeepSpeed 引擎加速
- WHU-CD 裁剪为 $1024 \times 1024$ patch 按 8:1:1 划分;S2Looking 3500 训练/500 验证/1000 测试;LEVIR-CD+ 637 训练/348 测试 —— 训练与测试划分方式
- 递进联合训练消融($A \rightarrow A+B \rightarrow A+B+C \rightarrow A+B+C+D$) —— 验证多源数据集联合训练的收益,为核心主张的关键证据
- 与 14+ 个 SOTA 方法横向对比 —— 包括 FC-Siam-diff、BIT、SAM-CD、Changer、LSKNet、SFCD-Net、Bi-SRNet、SCD-SAM、MambaSCD 等;其中部分 SCD 对比方法(表 2 带 * 者)在相同设置下重新实现以保证公平
4. 与前一篇相比,核心变化是什么?
本文和以前的论文有较大的不一致,UniChange 将二值变化检测(BCD)与语义变化检测(SCD)两种不同类型的检测任务,统一到了一个基于多模态大语言模型(MLLM)的生成式框架中。