读文献5-Change-Agent
本文最后更新于 2026年11月3日 晚上
Change-Agent
论文名称:Change-Agent: Towards Interactive Comprehensive Remote Sensing Change Interpretation and Analysis
阅读日期:2026.11.3
所属方向与编号:视觉语言驱动的变化检测-03
预知识
- 多级变化解译(MCI),任务框架 , 同时输出像素级变化掩膜和语义级文字描述的双重解读,是本文区别于以往单任务方法的关键定位
- 变化掩膜(Change Mask), 图像输出 , 一张与原图同尺寸的黑白/彩色图,标记出发生变化的像素区域
- 智能体(Agent), AI系统范式 , 能感知环境、理解指令、调用工具并自主完成任务的AI系统,Change-Agent就是面向遥感变化分析场景的专用智能体
- LPE(局部感知增强模块), 网络组件 , 使用1×1、3×3、5×1、1×5四种不同尺寸卷积核并行提取特征再融合,针对不同尺度和形状的地物增强局部感知能力
- GDFA(全局差分融合注意力模块), 网络组件 ,利用两时相特征之差(差异特征)生成空间注意力权重,让模型聚焦于感兴趣的变化区域、忽略无关干扰
1. 这篇论文要解决什么问题?
遥感影像变化解译(RSICI)领域目前存在两条主流技术路线:变化检测和变化描述。但二者各有致命短板——变化检测只能精确标出“哪里变了”(像素级掩膜),却无法理解变化背后的语义含义(如物体类别、空间关系、“出现/消失”等动态);变化描述能提供丰富的语义级解读,却无法给出精确的位置定位。此外,实际应用中用户常需要对结果做进一步加工(如统计变化物体数量、分析成因),这耗费大量时间且要求用户具备专业技术和编程能力。
让变化检测(像素级定位)与变化描述(语义级解读)在一个系统中同时完成,解决了以往单一技术要么“知道哪里变了却说不出变了什么”、要么“说得清却指不出位置”的割裂问题,且用户用自然语言对话即可完成检测、计数、成因分析等综合任务,无需编程技能。
2. 输入和输出,模型结构分别是什么?
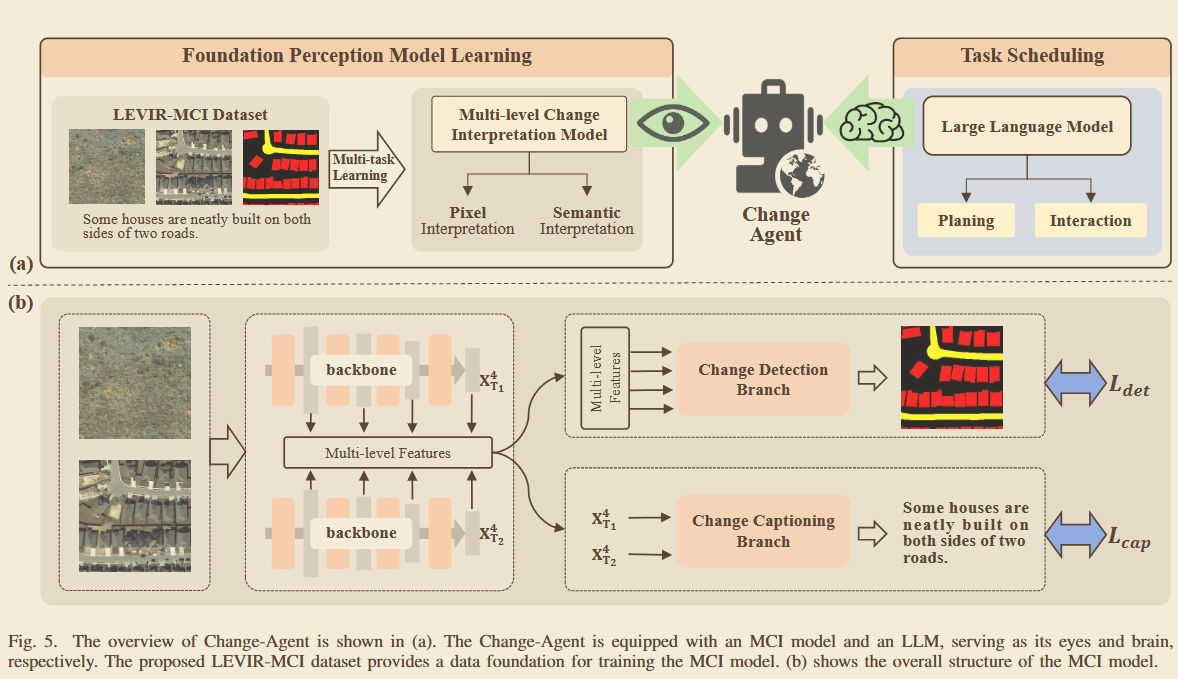
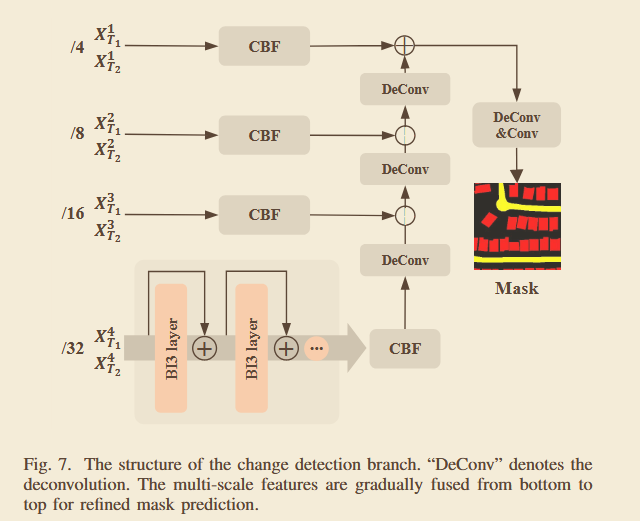
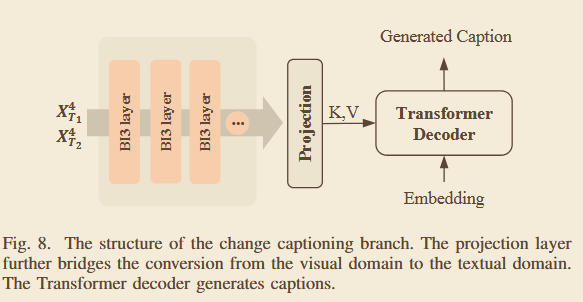
左图:变化检测的分支结构
右图:描述的分支结构
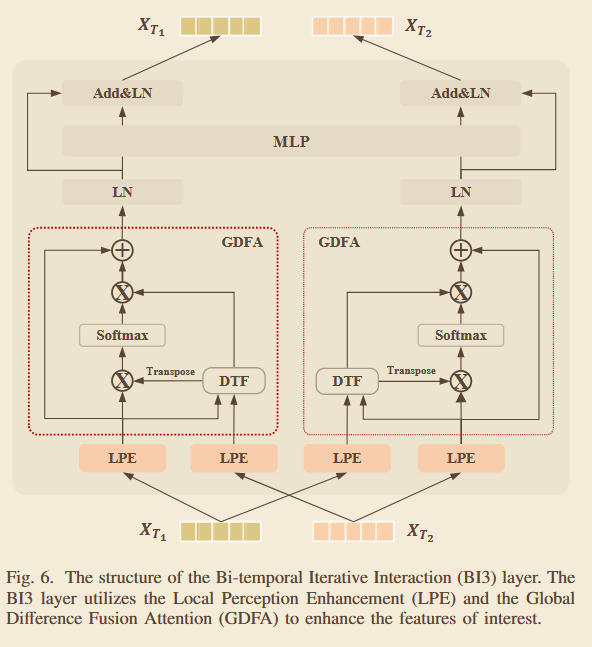
2.1 训练阶段
输入:
一对双时相遥感影像:$X_{T1} \in R^{(H \times W \times 3)}$(变化前影像)与 $X_{T2} \in R^{(H \times W \times 3)}$(变化后影像),尺寸 $256 \times 256$,分辨率 0.5 m/pixel,来自 LEVIR-MCI 数据集(共 10077 对)
配套监督标签:
① 像素级变化掩膜 GT Mask (0=未变化、1=变化道路、2=变化建筑)
② 5 条语义级变化描述句子之一
输出:
训练好的 MCI 模型(Segformer-B1 主干 + 3×BI3 检测分支 + 3×BI3 投影层+Transformer解码描述分支 )
Step 1. 影像进入孪生主干,提取多尺度特征
$X_{T1}$ 和 $X_{T2}$ 分别(但权重共享)通过 Siamese Segformer-B1,各自产出 4 个尺度的特征图:
- $X_{T1}^1\ (64 \times 64 \times 64)$、$X_{T1}^2\ (32 \times 32 \times 128)$、$X_{T1}^3\ (16 \times 16 \times 320)$、$X_{T1}^4\ (8 \times 8 \times 512)$,$X_{T2}$ 同理。 此时数据从“图像”变成了“两级共 8 个特征张量”。
Step 2. 双分支并行启动(共享主干特征,不共享分支参数)
- 检测分支取全部四个尺度特征(低层特征细节多,利于边界);
- 描述分支只取最高层 $X_{T1}^4$, $X_{T2}^4$(语义最丰富)。
检测分支
Step 3. 【检测分支】 BI3 层迭代增强高层特征
在 /32 尺度上,把 $(X_{T1}^4, X_{T2}^4)$ 依次通过 3 个 BI3 层(带残差连接)。单个 BI3 层内部:
3.1 LPE:以 $X_{T1}^4$ ($N \times C$, $N=64$, $C=512$) 为例_
- 并行过 $conv_{3 \times 3} / conv_{5 \times 1} / conv_{1 \times 5}$ 得到三路 $R^{(N \times C)}$
- concat 成 $F \in R^{(N \times 3C)}$
- $conv_{1 \times 1}$ 压回 $R^{(N \times C)}$,经 BN+ReLU,残差加上原 $X_{T1}^4$
- 输出 $X_{lp1} \in R^{(N \times C)}$
$X_{T2}^4$ 对称执行得到 $X_{lp2}$
3.2 GDFA:
先算差异 $D_i = X_{lp2} - X_{lp1} \in R^{(N \times C)}$
差分特征与自身特征逐元素相乘并线性投影 $IG = (D_i * X_{lp1}) \cdot W_d + b_d \in R^{(N \times d)}$
构造 $Q = X_{lp1} \cdot W_q + b_q$
$K = IG \cdot W_k + b_k$
$V = IG \cdot W_v + b_v$(均为 $R^{(N \times d)}$)
执行注意力 $\Phi_{GDFA} = \sigma(QK^T/\sqrt{d}) \cdot V$
输出 $R^{(N \times C)}$
左右两个 GDFA 通过 Transpose 对称交互,完成双时相双向融合
3.3 后处理:LN 归一化 $\rightarrow$ 残差 MLP 精化 $\rightarrow$ 输出增强后的双时相特征,进入下一个 BI3 层
3 层迭代后,得到判别性增强的高层双时相特征
Step 4. 【检测分支】四尺度 CBF 融合 + 自底向上精化
- 各尺度双时相特征对 $(X_{T1}^s, X_{T2}^s)$ $(s=1,2,3)$ 过 CBF 模块
- 先算 $S = \text{conv}_{3 \times 3}(X_{T2}^s - X_{T1}^s) + \cos(X_{T1}^s, X_{T2}^s)$(差异特征 + 余弦相似度)
- $F = \text{concat}([X_{T1}^s, S, X_{T2}^s])$_
- 最后 $\Phi_{\text{CBF}} = \text{conv}_{1 \times 1}(\text{ReLU}(\text{BN}(\text{conv}_{3 \times 3}(F))))$
- 输出该尺度融合特征
- 融合特征经 DeConv (反卷积) 自底向上 (/32→/16→/8→/4) 逐级上采样、逐级相加融合,最顶层再 DeConv+Conv
- 输出预测变化掩膜概率图 $p_{hw} \in R^{(256 \times 256 \times 3)}$ (3 类:背景/道路/建筑)
(注:四个尺度的特征图尺寸(Segformer-B1 输出):s=1 为 /4 分辨率(64×64),s=2 为 /8(32×32),s=3 为 /16(16×16),s=4 为 /32(8×8),通道数依次为 64/128/320/512)
Step 5. 【检测分支】计算损失 $L_{det}$
预测概率 $p_{hw}$ 与 GT 掩膜的 one-hot 向量 $y^e_{hw}$ 做像素级交叉熵:
$L_{det} = -(1/H \times W) \sum \sum y^e \log(p)$ → 标量
描述分支
Step 6. 【描述分支】投影层 + Transformer 解码器生成句子
增强后的 $(X_{T1}^4, X_{T2}^4)$ 进入投影层 $\Phi_{Pr}$ :
$F1 = \text{conv}_{1 \times 1}(\text{concat}([X_{T1}^4, X_{T2}^4]))$ ——双时相特征拼接降维
$F2 = \text{conv}_{3 \times 3}(\text{ReLU}(\text{BN}(\text{conv}_{1 \times 1}(F1))))$ ——非线性变换
输出 = $F1 + \text{conv}_{1 \times 1}(F2)$ (残差式融合) $\rightarrow$ 得到视觉域特征,形状为 (序列长度 $\times$ 512)
该特征作为 $K$、$V$,与词嵌入 (Query,嵌入维度 512) 一起输入 Transformer 解码器
解码器逐词生成描述句子的词概率分布 $p_l^{(v)} \in R^{(L \times V)}$ ($L$=词数,$V$=词表大小)
Step 7. 【描述分支】计算损失 $L_{cap}$
预测词分布与真值句子的词标签 $y_l^{(v)}$ 做交叉熵 :$L_{cap} = -(1/L) \sum \sum y \log(p) \rightarrow$ 标量
Step 8. 双损失平衡与参数更新
直接相加会失衡:训练中实测 $L_{cap} \approx 1.051$, $L_{det} \approx 0.024$,量级差约 40 倍 (后续实验部分已经说明,该方法不合适)
解决方案:$L_{total} = L_{det}/\text{detach}(L_{det}) + L_{cap}/\text{detach}(L_{cap})$(式20),$\text{detach}(\cdot)$ 截断梯度、只做量级归一化,保证两任务梯度贡献均衡
用 Adam ($lr=0.0001$, $\le 200$ epochs) 反向传播更新全部参数
训练调度:先联合训练,直到 ($\text{BLEU-4} + \text{MIoU}$) 连续 50 epochs 不再提升 $\rightarrow$ 冻结主干 $\rightarrow$ 两个分支分别继续微调
2.2 推理阶段
(一)MCI 模型单独推理
输入:一对新影像 (path_A, path_B),各 $256 \times 256 \times 3$。
Step 1. 影像过孪生 Segformer-B1 $\rightarrow$ 得 4 尺度双时相特征(同训练 Step 1,只是无梯度);
Step 2. 高层特征过 3 个 BI3 层增强(同训练 Step 3),四尺度过 CBF + 自底向上 DeConv 融合 $\rightarrow$ 输出 $256 \times 256$ 掩膜数组,每像素取概率最大类别(0/1/2) $\rightarrow$ 像素级结果;
Step 3. 同时,高层特征过投影层 $\Phi_{Pr}$ $\rightarrow$ 作为 $K, V$ 进 Transformer 解码器 $\rightarrow$ 自回归逐词生成 $\rightarrow$ 输出一条自然语言句子(如 “A road is built to join the road.”) $\rightarrow$ 语义级结果;
Step 4. 两个输出同时交付,即完成一次“多级变化解译”。
(二)Change-Agent 整体推理(MCI + LLM)
输入:用户自然语言指令(含影像路径),如“检测建筑和道路变化掩膜,建筑涂绿、道路涂蓝,存到 E:/mask.png,再数有几栋建筑变了”。
Step 1. 系统提示词以 system instruction 身份装入 LLM,声明可用工具:
change_detection(path_A, path_B, savepath_mask)(返回 $256 \times 256$ numpy 掩膜,0/1/2 三值)、generate_change_caption(path_A, path_B)(返回字符串)、compute_object_num(change_mask, object)(返回计数)Step 2. LLM 按 Thought $\rightarrow$ Action $\rightarrow$ Action Input 格式(ReAct 风格)推理,决定调用工具
'Visual_Change_Process_PythonInterpreter',并自主编写def solution():形式的完整 Python 代码
(论文中示例:调用 change_detection $\rightarrow$ 用 numpy 建 $(256,256,3)$ 的 mask_bgr $\rightarrow$mask==1涂蓝[255,0,0]、mask==2涂绿[0,255,0]$\rightarrow$ 调compute_object_num(mask,'building')$\rightarrow$ cv2.imwrite 保存 $\rightarrow$ return 数量);Step 3. 代码交由 Python 解释器执行:内部实际运行 MCI 模型产生掩膜/句子,并借助 OpenCV/NumPy 完成上色、保存、连通域计数等后处理;
Step 4. 执行结果作为 Response 回传给 LLM;
Step 5. LLM 结合工具结果与自身知识生成 Final Answer,形式包括:① 已保存/已上色的掩膜图片;② 文字描述;③ 数量统计(如“12 buildings have changed”);④ 变化成因推测、未来变化预测(此时仅凭 LLM 知识推理,不调用工具)
像素级变化掩膜 + 语义级描述句 + LLM 对话式综合分析结果(计数/上色/保存/成因/预测)——用户全程只需自然语言,无需任何编程
1 | |
以上为本文的核心模型 MCI 的结构图,注意,关于孪生 Segformer-B1是本文引入的一个通用骨干网络,它做了两件事:
- 把 256×256×3 的影像编码为四个尺度的双时相特征(64/128/320/512 通道),低层细节喂给检测分支,高层语义喂给描述分支,即从“像素”到“特征”的翻译
- 两个时相的影像分别通过同一套权重的 Segformer-B1(孪生结构)
注意: 本文的核心设计点在于 MCI 模型,对于LLM是如何与MCI交互的并没有提及,但是在后面的实验部分,通过一系列的实验在验证模型的可靠性的同时,间接的证明了在代码层面两个模型的交互。后续本文所提到的提示词都是向 LLM 输入的(包括代码的生成),MCI 作为 LLM 的调用工具。
3. 实验部分
评价指标:
描述任务的评价指标: BLUE-n / METEOR / ROUGE_L / CIDEr-D
BLEU看n-gram(连续n个词)精确匹配率
ROUGE-L找最长公共子序列
METEOR考虑同义词和词形变化
CIDEr-D基于TF-IDF加权的共识度,对常见词敏感
分数越高说明生成句子与人类参考越接近。
检测任务的评价指标:MIoU(Mean Intersection over Union,平均交并比)
MIoU = 对每一类分别计算“预测区域与真实区域的交集/并集”,再跨类取平均;它用 0–1 的单一数字,同时惩罚误报、漏报和边界不准,是衡量“掩膜画得准不准”最均衡也最挑剔的指标
对某一类 $c$,IoU 定义为”交集面积 ÷ 并集面积“:
$$
IoU_c = \frac{TP_c}{TP_c + FP_c + FN_c}
$$
- 分子 $\text{TP}$:两区域都覆盖的部分(预测且真实的变化);
- 分母 $\text{TP}+\text{FP}+\text{FN}$:两区域至少一方覆盖的部分;
- $\text{IoU} \in [0, 1]$:1 表示完全重合,0 表示完全错位。
实验细节:
- 数据集:该团队原有的数据集 **LEVIR-CC **数据集扩展而来(256 × 256 × 3),新增像素级掩膜标注(① 三分类掩膜(0=未变化,1=道路变化,2=建筑变化)② 每对影像 5 条人工描述句)
- 环境+框架: NVIDIA RTX 4090 GPU , PyTorch
- 优化器: Adam
- 学习率:初始 1e-4
- 训练轮数:最大 200 epochs
- 词嵌入维度:512
- 骨干:权重共享孪生 Segformer-B1(预训练权重初始化)
- 训练策略:首先训练,当 BLEU-4 + MIoU 之和连续 50 epochs 不再提升时,冻结骨干,两分支继续分别微调
消融实验:
- Baseline :用普通 Transformer 编码层处理双时相特征(即拆掉整个 BI3)
- +LPE:只加局部感知增强(多核卷积并行+残差)
- +GDFA:只加全局差分融合注意力(差异特征做 K/V)
- 完整的 BI3:LPE + GDFA 一起上
关于损失函数的设置:
多任务损失归一化平衡 $$L = \frac{L_{det}}{\text{detach}(L_{det})} + \frac{L_{cap}}{\text{detach}(L_{cap})}\tag{20}$$
作者发现$L_{det}$和$L_{cap}$相差比较大(约40倍),在最后训练的结果可能是大的一方占据了主导的地位,因此采取了这样的改进,作者比较了改进前后相关指标的提升度,发现改进后各项指标有所提升。
既然这样子,他设计后并没有给出他们之间数值的对比,难道数值差距缩小了吗,也不一定吧,缩小了可能有所提升,但是变大了也不排除也会有所提升。
式20(其中一个) 数值恒为 1,为什么依然“合法”
判断一个损失函数能不能用,标准只有一条:
$\partial L/\partial \theta$ 是否良定义、是否指向“让任务损失下降”的方向。
式20 满足:
$$
\frac{\partial}{\partial \theta} \left[ \frac{L_{det}}{\text{detach}(L_{det})} \right] = \frac{1}{\underbrace{\text{detach}(L_{det})}_{\text{正的常数}}} \cdot \frac{\partial L_{det}}{\partial \theta}
$$
- 方向不变:系数恒为正,梯度方向与原始 $\partial L_{det}/\partial \theta$ 完全一致——下降方向没错;
- 幅度可调:系数就是动态权重;
- 所以优化器拿到的是一个方向正确、幅度动态加权的梯度——作为训练目标完全合法。
换句话说:式20 丢掉的只是“数值的可读性”,丢不掉“梯度的有效性”。损失函数的灵魂在梯度,不在数值
也就是说虽然可以正常的反向传播进行训练(因为反向传播是求导后的公式),但是我们通过观察loss来验证模型是否提升的方法失效了,这可能也是作者改进后对比的是评价指标的原因吧。
4. 与前一篇相比,核心变化是什么?
本文核心模型 MCI 同时输出两路结果:像素级上对每像素取概率最大类别(0 未变化 / 1 新增 / 2 消失)得到语义变化掩膜,回答“哪里变了”;语义级上由 Transformer 解码器自回归生成一条自然语言句子(如 “A road is built to join the road.”),回答“变了什么”,二者通过共享特征间接对齐而非串联流水线。在此基础上,本文进一步将 MCI 与 LLM 相连接,构建了一个简单的 Change-Agent,使 LLM 能够调用 MCI 的检测结果对图像变化进行交互式解读。
而上一篇(Semantic-CD)是一个开放词汇的语义变化检测网络:以冻结的 RemoteCLIP ViT-L/14 为共享骨干、仅微调轻量 BCSF 适配器,检测(BCD)与语义(SCD)两个分支采用两阶段完全解耦训练,同时输出二值变化掩膜(回答“哪里变了”)和任意类别的语义标签掩膜(由 CLIP 文本编码器开放编码,回答“变成了什么”)——语义知识来自基础模型预训练先验,多任务靠解耦隔离而非交互。
本文问的是“两个任务怎么互相帮”(多任务协同范式),Semantic-CD 问的是“预训练知识怎么注入”(基础模型范式)。
对比 RSICCformer,本文的 MCI 是检测与描述联合的多任务模型,且在外接 LLM 后进一步构成了可交互的 Change-Agent,而 RSICCformer 仅是单向的单任务变化描述模型。
既然本文是实现的交互式的任务,为什么没有描述核心模型与LLM是如何交互的呢