读文献4-RSICCformer/Semantic-CD
本文最后更新于 2026年11月1日 下午
RSICCformer
论文名称:Remote Sensing Image Change Captioning with Dual-branch Transformers: A New Method and a Large Scale Dataset
阅读日期:2026.10.30
所属方向与编号:视觉语言驱动的变化检测-01
预知识:
- 人类一致性:选一句作假设句、其余四句作参考,计算BLEU-N/ROUGE-L/METEOR。
- 双时相影像(bi-temporal images)→ 数据形式 → 同一地点、两个不同时间点拍摄的两张影像对,是变化分析的基本输入单元。
- 孪生网络(Siamese network)→ 网络结构 → 两个结构完全相同、权重共享的分支网络,分别处理两路输入(这里就是“前”图和“后”图),便于比较两者的特征。
- 交叉编码(CE,Cross-Encoding)→ 注意力模块 → 与普通Transformer的“自注意力”(自己关注自己)不同,交叉注意力让一张图的特征去“查询”另一路特征,从而建立两路信息之间的联系。
BLEU-4 / ROUGE-L / METEOR / CIDEr-D → 文本自动评价指标 → 都是通过比较机器生成的句子和人工参考句子的重合度来打分。BLEU看n-gram(连续n个词)精确匹配率;ROUGE-L找最长公共子序列;METEOR考虑同义词和词形变化;CIDEr-D基于TF-IDF加权的共识度,对常见词敏感。分数越高说明生成句子与人类参考越接近。
自回归生成(autoregressive generation)→ 生成方式 → 逐词生成:先输出第一个词,把它加入输入再预测第二个词,如此循环直到输出“结束”符。就像一个词一个词地写作文,每写一个词都要参考前面已写的全部内容。
Teacher forcing(教师强制)→ 训练技巧 → 训练时解码器不是用自己上一步生成的词,而是直接用标准答案(真值词)作为下一步的输入,加速且稳定训练。
1. 这篇论文要解决什么问题?
背景:传统遥感变化检测只能在像素级标出“哪里变了”,无法说明“变了什么”(如建了楼、修了路);而现有的图像变化描述研究局限于合成简单场景,遥感领域既缺乏大规模真实数据集,也没有能充分挖掘特征差异、捕捉多重变化的有效方法
让AI看懂两张卫星图,并用一句话说出“这里发生了什么变化”。具体来说是3个方面:
- 提出新任务 RSICC,让AI自动用自然语言描述两幅遥感影像的变化
- 构建首个大规模真实数据集 LEVIR-CC
- 提出新模型 RSICCformer,利用影像逐像素配准的先验,通过差分编码+孪生交叉编码+多阶段融合,捕捉多重感兴趣变化、忽略无关干扰
2. 输入和输出分别是什么?
输入:一对双时相遥影像 $I = (I_{t0}, I_{t1})$,即同一地点、前后两个时刻各一张 256×256 的 RGB 卫星影像(“前”图 $I_{t0}$ 与“后”图 $I_{t1}$,逐像素配准、无视角变化)
输出:一句描述两图差异的自然语言句子(Caption),例如 “Many buildings appear around the road”
2.1 训练阶段
训练时,模型同时接收影像对 + 真值句子,目标是让模型学会“看图 → 写句子”
step 1. CNN特征提取
- 两幅影像 $I_{t0}$、$I_{t1}$ 分别通过权重共享的改进版 ResNet-101 backbone(conv5_x 及后续层替换为 1×1 卷积,通道 1024→512)
- 输出两张特征图 $X_{t0}$、$X_{t1}$(空间尺寸 H×W,通道 d=512)
step 2. 展平 + 位置编码
- 两张特征图分别展平为序列:$(H, W, d) → (H×W, d)$,每个像素位置成为序列中的一个 token
- 加上可学习的 2-D 位置编码(实验证明只在此处加编码效果最佳)
- 得到两条特征序列,送入双分支 Transformer 编码器(DTE)
Step 3. 双分支 Transformer 编码器(DTE,N=3 个阶段循环执行)
差分编码模块(DE):两时相特征逐元素相减,$X_{dif|t0} = X_{dif|t1} = X_{t1} − X_{t0}$(采用 DE1 策略,保留时序信息),输出蕴含变化位置与幅度的“差异表示”
孪生交叉编码模块(CE):两个对称分支中,Q 来自该时刻图像特征 $X_i$,K 和 V 来自差异特征 $X_{dif|i}$;经 8 头交叉注意力 + Add& Norm + 前馈网络 + Add& Norm,输出聚焦于变化区域的增强特征 $X_{t0}$、$X_{t1}$
- DE1:直接相减 $X_{dif} = X_{t1} − X_{t0}$(保留符号,即“时序信息”)
- DE2:取绝对值 $Abs(X_{t1} − X_{t0})$
- DE3:$RELU( conv( [ X_{t1} − X_{t0}; X_i] ) )$,即把差值和当前时刻特征拼接后做卷积变换
多阶段双时相融合模块(MBF):将两分支特征在通道维拼接,加上上一阶段的累积融合特征,经 1×1→3×3→1×1 卷积残差单元融合后再层归一化。三个阶段分别关注不同变化(如阶段1道路、阶段2建筑、阶段3植被),最终融合为揭示多重变化、排除无关干扰的表示 $X_{fus}$
Step 4. 解码器并行训练
- 真值句子先做词嵌入(词嵌入维度 1024,从头训练),加上正弦/余弦位置编码
- 解码器每层:掩码自注意力(防止看到未来的词)→ 编码器-解码器注意力(Q 来自句子嵌入,K/V 来自 Step 3 的 $X_fus$)→ 前馈网络
- 经线性层 + Softmax,输出每个位置的词概率向量 $p_t ∈ R^K$
Step 5. 计算损失、更新参数
- 采用 Teacher Forcing 教师强制:解码器每一步的输入是真值词,而非模型自己生成的词
- 输出的词概率分布与真值句子计算交叉熵损失
- 反向传播更新整个网络参数
2.2 推理阶段
推理时,模型只接收影像对,没有任何真值句子,需要逐词生成答案。
Step 1–3. 视觉特征提取与编码(与训练完全相同)
- 影像对 → ResNet-101 → 展平 + 位置编码 → DTE 三个阶段(差分编码DE → 交叉编码CE → MBF 融合);
- 得到最终融合特征 $X_{fus}$
Step 4. 自回归逐词生成
- 起始输入:特殊符号 “start” 的词嵌入
- 第 1 次迭代:解码器根据 $[ start ]$ 与 $X_{fus}$,经掩码自注意力 + 交叉注意力($K/V = X_{fus}$)+ Softmax 预测第 1 个词$w_1$
- 第 2 次迭代:将 $w_1$ 拼入序列 $[ start ; w_1 ] $,再次预测 $w_2$
- 如此循环,每生成一个词就拼入序列再预测下一个
- 终止条件:当生成的词为 “end” 时停止
Step 5. Beam Search 束搜索优化
beam=1 即贪心搜索;增大 beam 可同时保留多条候选句子路径(本文实验表明,当 beam=3 时,评价指标区域平和)
贪心搜索(Greedy Search)→ 推理策略 → 生成句子的每一步,都只选当前概率最高的那一个词,选完就丢弃其他所有可能性,一条路走到黑
束搜索(Beam Search)→ 推理策略 → 每一步同时保留概率最高的 K 条候选句子路径(K 就叫 beam size 束宽),让它们并行“生长”,最后从 K 条完整句子中挑出整体概率最高的一条
采用束搜索,这样即使某条开头看起来不咋样的路径后来变得更好,也不会被提前“误杀”
Step 6. 输出最终句子
- 停止后输出完整的变化描述句子,如 “A road appears in the desert”
3. 整体流程是什么?各模块分别做什么?
1 | |
① CNN特征提取器 :把原始像素转化为高层语义特征——即从“一堆彩色格子”变成“这里有建筑、这里有道路”的特征表示
通过两幅影像分别通过权重共享的改进版 ResNet-101 实现。
输入输出:输入 256×256 影像 → 输出两张特征图 $X_{t0}$、$X_{t1}$
② 双分支 Transformer 编码器(DTE)( 核心创新 )
分为三个模块:
- 差分编码模块:生成“差异表示”——直接告诉后续模块“两张图哪些位置的语义不一样、差多少”
- 孪生交叉编码模块:让每幅图的图像特征去“查询”差异信息,从而把变化区域“高亮”到特征上
- 多阶段双时相融合模块:融合当前阶段两分支的输出和之前所有阶段的累积结果,得到既包含多重感兴趣变化、又排除无关干扰的融合表示 $X_{fus}$
③ 描述解码器:把融合特征 $X_{fus}$ “翻译”成一句自然语言
- 标准 Transformer 解码器,每层包含三部分:
- 掩码自注意力:保证逐词预测只依赖已生成的词
- 编码器-解码器注意力:Q 来自句子嵌入,K/V 来自 $X_{fus}$,即让句子去“查询”视觉变化信息
- 前馈网络 + 残差 + 层归一化
- 输出:线性层 + Softmax 得到词概率分布,逐词生成直到 “end”
4. 实验细节
训练阶段使用Adma优化器 ,词嵌入的维度在512维,最大训练轮数40,初始学习率0.0001。当验证集上的 BLEU‐4 指标连续三个 轮数下降时,学习率将衰减0.7倍。
评价指标:使用 BLEU-N ( N=1,2,3,4) / ROUGE-L / METEOR / CIDEr-D ,指标分数越高,生成句子与参考句子之间 的相似度就越高
在论文之前,已经说明了本文使用的差异编码为
DE1,同时在实验方面,本文对上述评价指标做了实验分析,并于基线做了对比。基线采用没有差分编码模块的孪生Transformer编码器来分别处理双时态特征
消融实验:本文对 CE和MBF 进行消融实验,用来验证该模块的有效性。分别从三个方面评估性能指标:
- 仅测试有变化的图像对
- 仅测试没有变化的图像对
- 在整个测试集上进行测试
测试的数值,代表的是该模型生成对应图片的描述的准确率
Q: 既然 DTE 是本文的核心创新模块,那么本文的消融实验为什么没有DE模块?
A: 关于 DE 的消融实验,本文并没有将他写入该部分,因为 DE 模块含有三中不同的策略,为了对比不同策略的有效性,为此,在消融实验之前,已经根据 baseline 对这三种策略进行对比实验。
注意:该对比实验的 baseline 采用的和后面的消融实验的 “在整个测试集上进行测试” 的 baseline 是一样的。对比之后,本文采用的是 DE1 的策略。
本文还对比了当时最优的合成图像变化描述,包括 四种基于 LSTM (Capt-Rep-Diff , Capt-Att, Capt-Dual-Att , DUD)和两种基于 Transformer (MCCFormers-S,MCCFormers-D)的方法 。
关于本文的骨干网络,本文对比了5中经典的之后采取了改进后的 ResNet‐101 。
骨干网络就是在输入 DTE 之前的图像特征提取的阶段,将 ResNet‐101 的
conv5_x及后续层替换为1*1卷积,同时将特征通道从1024降到512
关于位置嵌入:
- 在双时相特征序列输入双分支 Transformer编码器之前,使用可学习的 2‐D位置嵌入 ,将空间位置信息融入模型中
- 在标题解码器中, 使用正弦和余弦函数对序列进行位置嵌入
论文在 IV. E 部分说词向量嵌入为 1024,但是又在实验部分 V. A 部分又说,词向量维度为 512 ??????
解码器的 K/V 投影层输入维度跟着编码器输出走——只要模型用了 MBF 把两分支特征通道拼接(512+512),就填 1024。如果跑的是不拼接的变体(单路 512 维特征),就填 512。(代码中注释有: args.feature_dim_de = 1024 # 当有concat是1024,否则为512)
Semantic-CD
论文名称:Semantic-CD: Remote Sensing Image Semantic Change Detection towards Open-vocabulary Setting
阅读日期:2026.11.1
所属方向与编号:视觉语言驱动的变化检测-02
预知识:
- 二值变化检测(BCD),任务类型 , 只回答“哪里变了”,输出一张黑白掩膜,变了的区域是白色,没变的是黑色,但不告诉你变成了什么。
- 语义变化检测(SCD),任务类型 , 进一步回答“从什么变成了什么”,比如“绿地变成了建筑物”
1. 这篇论文要解决什么问题?
背景
遥感影像的语义变化检测(SCD)不仅要找出“哪里变了”,还要识别“从什么变成了什么”,实用价值高于二值变化检测(BCD)。但现有SCD方法都在封闭类别集下工作,只能识别训练时见过的类别,无法泛化到新的地物类型。CLIP等视觉-语言基础模型虽具备开放词汇能力,却难以直接辨别双时相影像中的有效变化,且SCD领域也缺乏覆盖广泛类别的数据集。
让变化检测模型从“只认识训练时见过的类别”变为“原则上能识别任意文字描述的类别”,即开放词汇能力,从而摆脱对固定类别集的依赖。
2. 输入和输出流程分别是什么?
输入:
- 双时相遥感影像:变化前影像 $I_1 ∈ R^{H×W×3}$ 和变化后影像 $I_2 ∈ R^{H×W×3}$($H×W$为图像尺寸,3为RGB通道)
- 类别集合 C:地物类别词的集合(如SECOND数据集的6类:非变化、低植被、非植被地表、树木、水体、建筑物、操场等),SCD分支需要用它来生成开放词汇提示
- 仅训练阶段需要:真值标签,包括二值变化检测掩膜 $y^{bcd}$ 和变化前/后时相的语义变化检测掩膜 $y^{scd-1/2}$
输出:
- 二值变化检测掩膜 $M_{BCD} ∈ R^{H×W}$:每个像素为“变化/未变化”二值
- 语义变化检测掩膜 $M^1_{SCD}、M^2_{SCD} ∈ R^{H×W×C}$:变化前后两个时相各自的逐像素类别概率图(C为类别数)
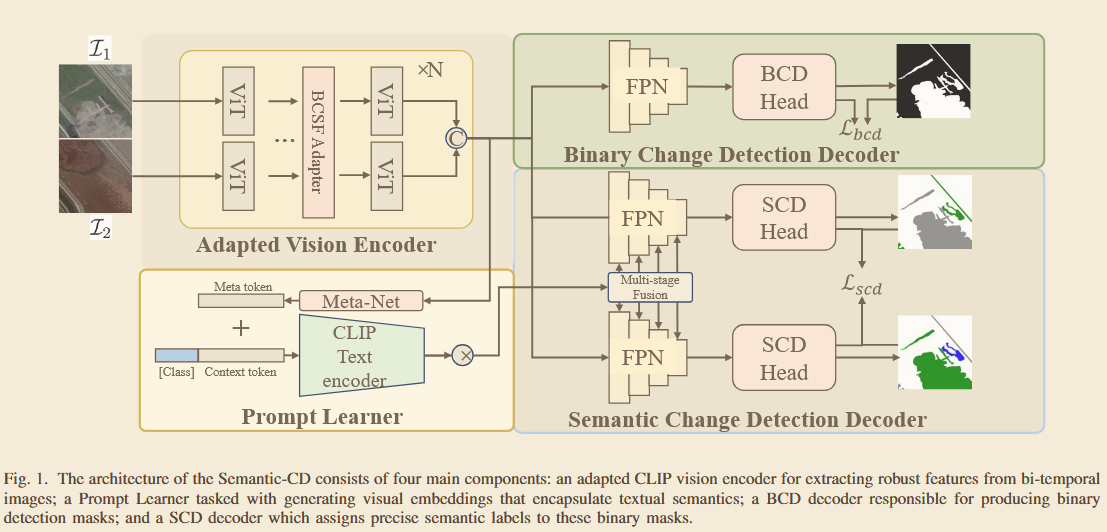
2.1 训练阶段
Step 1.(BCD分支训练)双时相图像进入适配后的CLIP视觉编码器
$I_1$、$I_2 $送入 Bi-temporal CLIP 视觉编码器 $Φ_{CLIP-enc}$(内部在四个全局注意力层嵌入了BCSF适配器),得到特征 $F_1$、$F_2 ∈ R^{N×C}$( N 为 token 数,C 为通道数)。此阶段BCSF参数参与更新,CLIP其余骨干参数冻结。
Step 2.(BCD分支训练)BCD解码器生成二值掩膜
$F_1$、$F_2$ 拼接后经 SimpleFPN 多尺度采样($Φ_sampling$)得到 4 级多尺度特征 { $F’_i ∈ R^{H/2^{i+1}×W/2^{i+1}×512}, i∈{1,2,3,4}$ },经卷积精化($Φ_{conv}$)、双线性插值统一分辨率($Φ_{resize}$)、拼接与1×1卷积投影($Φ_{proj}$)后输出 $M_{BCD}$,与真值 $y^{bcd}$ 计算二元交叉熵损失 $L_{bcd}$反向传播。
注意:此阶段 prompter(提示学习器)和 SCD 解码器全部冻结固定,不参与梯度更新
Step 3.(SCD分支训练)提示学习器构建语义代价体
特征 $F_1$、$F_2$ 和类别集合 $C$ 进入提示学习器 $\Phi_{\text{prompt-learner}}$:元网络 $\Phi_{meta}$ 从 $F_i$ 提取实例级变化语义元标记 $p_i^m = \Phi_{meta}(F_i)$;与任务可学习标记 $p^t$ 相加得上下文嵌入 $p_i^c = p_i^m + p^t$;再与每个类别词嵌入 $p_j^{\text{text}}$ 拼接送入 CLIP 文本编码器得到 $t_{i,j}$;最后与视觉特征做余弦相似度($\Phi_{sim}$),生成像素级代价体 $F_{cv}^1, F_{cv}^2 \in \mathbb{R}^{H’ \times W’ \times C}$($H’ \times W’$ 为低分辨率特征图尺寸)。
Step 4.(SCD分支训练)SCD解码器融合并输出语义掩膜
视觉特征 ${F_i}$ 与代价体 ${F^{cv}_i}$ 各自经共享参数的 SimpleFPN 生成多尺度特征,逐级相加融合($F’_i = F^i_{cv} + F_i$),经卷积、插值统一尺度后由解码映射层输出 $M^1_{SCD}$、$M^2_{SCD}$,与真值 $y^{scd-1/2}$ 计算交叉熵损失 $L_{scd}$反向传播。
注意:此阶段视觉编码器和 BCD 解码器全部冻结
关于${F^{cv}_i}$ 和 ${F_{cv}^i}$ 在本文中都是同一个意思,论文对于此处的公式有明显的笔误
$\hat{y}_i$ 和 $y_i$ 指的是单个像素的预测值和真值。而 $M_{BCD}$、$M_{SCD}^1$、$M_{SCD}^2$ 是整幅掩膜($H \times W$ 的图像)。它们的关系是:
$$
\hat{y}_i^{bcd} = M_{BCD} \text{ 的第 } i \text{ 个像素的预测值}
$$
$$
\hat{y}_{i,c}^{scd-1/2} = M_{SCD}^{1/2} \text{ 的第 } i \text{ 个像素在第 } c \text{ 类上的概率}
$$
所以完整写出来应该是:
$$
\mathcal{L}_{bcd} = \text{BCE} \left( M_{BCD}, y^{bcd} \right) = -\frac{1}{N} \sum_{i=1}^{N} \left( y_i^{bcd} \log \hat{y}_i^{bcd} + (1 - y_i^{bcd}) \log(1 - \hat{y}_i^{bcd}) \right)\tag{1}
$$
$$
\mathcal{L}_{scd} = \text{CE} \left( M_{SCD}^1, y^{scd-1} \right) + \text{CE} \left( M_{SCD}^2, y^{scd-2} \right) = -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C-1} y_{i,c}^{scd-1/2} \log \hat{y}_{i,c}^{scd-1/2}\tag{2}
$$
上标“1/2”隐含了对两幅掩膜 $M_{SCD}^1$ 和 $M_{SCD}^2$ 的求和。式(6)中只写了一个 $\mathcal{L}_{scd}$,但 SCD 分支实际输出变化前、变化后两幅语义掩膜。作者用上标“1/2”(意为“时相1和时相2”)把两幅掩膜的损失合并成一个式子表达,即:
$$
\mathcal{L}_{scd} = \mathcal{L}_{scd-1} + \mathcal{L}_{scd-2}
$$
2.2 推理阶段
推理时只需输入 $I_1$、$I_2$ 和类别词集合 C(无需任何真值标签),流程与训练前向传播完全一致,但所有参数固定
Step 1. 双时相图像 → 适配后的CLIP视觉编码器 → 提取特征 $F_1$、$F_2$;
Step 2. $F_1$、$F_2$ → BCD解码器 → 输出二值变化掩膜 $M_{BCD}$(哪里变了);
Step 3. $F_1$、$F_2$ 与类别集合 $C$ → 提示学习器(元标记由当前图像内容动态生成,即“实例级语义引导”) → CLIP文本编码器 → 余弦相似度 → 代价体 $F_{cv}^1$、$F_{cv}^2$;
Step 4. 代价体与视觉特征经SCD解码器多尺度融合 → 输出前后时相语义掩膜 $M_{SCD}^1$、$M_{SCD}^2$(变成了什么)。
双时相影像 → BCSF适配后的CLIP编码器提取共享特征 → 兵分两路
一路拼接做多尺度二值分割(BCD,回答”哪里变了”)
一路驱动开放词汇提示器生成代价体再与视觉特征逐尺度融合(SCD,回答”变成了什么”)
三张输出图组合得到完整语义变化结果