读文献7-RCD/OpenDPR
本文最后更新于 2026年11月14日 下午
RCD
论文名称:Referring Change Detection in Remote Sensing Imagery
阅读日期:2026.11.14
所属方向与编号:视觉语言驱动的变化检测-07
预知识
- RCD(Referring Change Detection,指称式变化检测), 新任务范式 , 给定变化前后两期影像($T1/T2$) + 一句描述类别的话语,输出只包含该类别变化的一张掩膜。数学上即学习 $M = f(I_{pre}, I_{post}, C)$,其中 $C$ 是文本意图
- 扩散模型(Diffusion Model / DDPM) , 生成式 AI , 像逐步给照片加噪点、再学会一步步把噪点“擦掉”的模型,擦噪点的过程可以按文字指令“往某个方向擦”,从而生成符合指令的新图
- VAE(变分自编码器) ,压缩器, 把大图像压缩成很小的数字特征(潜空间),扩散计算在小特征上做,省算力,最后再解压回图像
- InstructPix2Pix ,图像编辑模型 , 输入“原图 + 一句指令(如‘把树变成房子’)”就能生成编辑后图像的模型
- CLIP , 视觉-语言模型 , 由 OpenAI 训练的图文对齐模型,能把文字变成向量,使语义相近的文字向量在空间中彼此接近,本文用它把“水体”“建筑”这类词变成网络能理解的“意图向量”
- Classifier-free guidance , 采样技巧 , 生成时同时算“无条件”和“有条件”两种预测,按系数放大两者的差,让生成结果更贴合指令,$s_T$ 越大指令服从性越强
- Mamba / VMamba / VSSB , 新型视觉骨干网络, 用“状态空间模型”替代 Transformer 的注意力,处理长序列时计算量随长度线性增长(更快更省),VMamba 是其图像版
- Siamese(孪生)结构 , 网络设计 , 两个完全相同、权重共享的分支分别处理两期影像,天然适合比较“前后差异”
- 交叉注意力(Cross-Attention) , 注意力机制变体 , 一组特征做“提问”(query),另一组做“线索库”(key/value),这里让视觉特征去“检索”文字意图,实现多模态对齐
1. 这篇论文要解决什么问题?
遥感变化检测经历了从二值变化检测(BCD,只标“哪里变了”)到语义变化检测(SCD,标注“变成了什么类别”)的演进,但两者都无法满足用户的定向需求。传统 BCD 无法区分变化类型;SCD 则依赖预先定义好的固定类别集合,导致模型输出通道数与类别数硬绑定——而各数据集类别定义互不一致(如”impervious surface”与”bare ground”在不同数据集中或分或合),模型难以跨数据集泛化,混合数据集训练几乎不可行。此外,SCD 数据稀缺且类别极度不均衡(如 SECOND 中”playground”仅占变化面积的 0.38%、129 张图像,而非植被地表占 43%、2,689 张),模型对稀少类别几乎学不会。
论文提出 Referring Change Detection(RCD)新任务,让用户通过自然语言指定感兴趣的变化类别,模型只输出该类别的变化图,从而摆脱固定类别绑定,实现跨数据集混训。
2. 输入和输出分别是什么?
论文包含两个模型:RCDGen(合成数据生成器,为 RCDNet 服务)和 RCDNet(变化检测网络,最终任务模型)
2.1 RCDGen
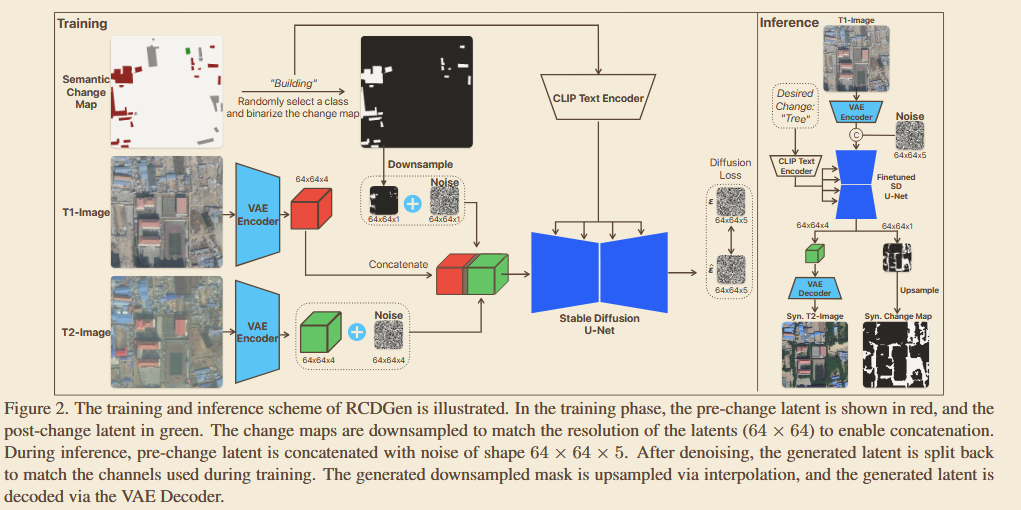
2.1.1 训练阶段
输入:
| 输入项 | 维度 | 来源 |
|---|---|---|
| T1-image(变化前图像) | $H \times W \times 3$ | SECOND / CNAM-CD / LEVIR-CD / LEVIR-CD+训练集 |
| T2-image(变化后图像) | $H \times W \times 3$ | 同上 |
| Semantic Change Map(语义变化图) | $H \times W$(多类标签图) | 同上 |
| 类别名(文本,如“Building”) | 字符串 | 从该样本语义变化图中随机选取的一个类别 |
输出:UNet 预测的噪声 $\hat{\epsilon}_\theta$,与真实噪声 $\epsilon$ 之间计算扩散损失(式 1),仅此一项——训练阶段不生成图像,只学习“如何按指令去噪”。
$$
L = \mathbb{E}_{\epsilon \sim \mathcal{N}(0,1)} \left[ \left| \epsilon - \epsilon_\theta(z_t, t, \mathcal{E}(T1), c_T) \right|_2^2 \right], \tag{1}
$$
其中 $\mathcal{E}$ 表示 VAE 编码器,$\epsilon_\theta$ 表示 UNet,$c_T$ 代表文本嵌入,$t$ 是随机时间步,而 $z_t$ 定义为:公式(2)
步骤如下:
step 1. 双图 VAE 编码
T1 和 T2 分别送入同一个 VAE 编码器 E,压缩到潜空间:
- T1 $\rightarrow$ E(T1): $64\times64\times4$(图 1 中红色张量,即“变化前潜特征”)
- T2 $\rightarrow$ E(T2): $64\times64\times4$(图 1 中绿色张量,即“变化后潜特征”)
($H\times W\times3$ 的原图被压缩为 $64\times64\times4$ 的潜特征,潜空间分辨率固定为 $64\times64$。)
step 2. 构造类别特定掩膜
从语义变化图中随机选中一个类别(如“Building”),把该类以外的所有像素屏蔽(置零),得到该类的二值变化图;再下采样(Downsample)到 $64\times64$,得到:
- 下采样掩膜 $\tilde{m}$: $64\times64\times1$
step 3. 通道拼接($\oplus$ 表示通道维拼接)
- T1 侧: E(T1) $\oplus$ $\tilde{m}$ $\rightarrow$ $64\times64\times5$(4 通道图像潜特征 + 1 通道掩膜)
- T2 侧: E(T2) $\oplus$ $\tilde{m}$ $\rightarrow$ $64\times64\times5$
step 4. 前向扩散加噪(关键设计:只加一半)
论文明确指出:随机噪声只加在“后影像潜特征 + 掩膜”这一半上,而 T1 侧的 $64\times64\times5$ 保持干净(这是 InstructPix2Pix 式的图像条件设计,保证“原图信息”在去噪时始终可见)。带噪隐变量由式 (2) 给出:
$$
z_t = \sqrt{\alpha_t} \times [E(T2) \oplus \tilde{m}] + \sqrt{1 - \alpha_t} \times \epsilon, \quad \epsilon \sim \mathcal{N}(0, 1)\tag{2}
$$
其中 $\alpha_t$ 是噪声调度(noise schedule)系数,$t$ 是随机时间步。
step 5. 文本条件编码
类别名经 CLIP Text Encoder 得到文本嵌入 $c_T$,与干净的 T1 侧潜特征一起作为 UNet 的条件。
step 6. 噪声预测与扩散损失
微调后的 Stable Diffusion U-Net 记为 $\epsilon_\theta$,输入为 $(z_t, t, E(T1), c_T)$,预测噪声并用式 (1) 计算损失:
$$
L = \mathbb{E}_{\epsilon \sim \mathcal{N}(0,1)} \left[ \left| \epsilon - \epsilon_\theta(z_t, t, E(T1), c_T) \right|_2^2 \right]\tag{1}
$$
训练配置:基于 Hugging Face Diffusers 库,从预训练 InstructPix2Pix checkpoint 出发微调 Stable Diffusion 15,000 个 iteration,$batch size = 4$
2.1.2 推理阶段
输入:
- T1-image(变化前图像) ,$H×W×3$,来自真实数据集
- 期望变化类别(文本,如 “Tree”),字符串,用户想要“植入”的变化类别
不需要 T2 图像,也不需要任何语义分割掩膜,相对 ChangeAnywhere 、Changen (推理时依赖分割掩膜)和 Changen2 (依赖 SAM 生成轮廓)的核心区别。
输出:
- Syn. T2-Image(合成变化后图像),$H×W×3$,作为合成样本的“变化后”图像
- Syn. Change Map(合成变化图),$H×W$,作为合成样本的“变化标签”
这两项输出恰好构成 RCDNet 训练所需的三元组中的两项,与真实 T1 一起喂给 RCDNet 预训练
步骤如下:
step 1. VAE 编码:T1 $\rightarrow$ E(T1),$64\times64\times4$。
step 2. 拼接纯噪声:将 E(T1)($64\times64\times4$)与形状 $64\times64\times5$ 的纯随机噪声在通道维拼接,作为待去噪的初始隐变量(对应训练时 $z_t$ 中“后影像+掩膜”那 5 个通道的位置——推理时它们是未知的,全部用噪声填充,靠网络去“脑补”)。
step 3. 双条件去噪迭代:文本 “Tree” $\rightarrow$ CLIP 文本编码器 $\rightarrow$ $c_T$。采用 InstructPix2Pix 的双条件 classifier-free guidance(式 3)修正每一步的噪声估计:
$$
\begin{aligned}
\tilde{\epsilon}_\theta(z_t, E(T_1), c_T) &= \epsilon_\theta(z_t, \varnothing, \varnothing) \\
&\quad + s_I \cdot (\epsilon_\theta(z_t, E(T_1), \varnothing) - \epsilon_\theta(z_t, \varnothing, \varnothing)) \\
&\quad + s_T \cdot (\epsilon_\theta(z_t, E(T_1), c_T) - \epsilon_\theta(z_t, E(T_1), \varnothing))
\end{aligned}\tag{3}
$$
其中 $\varnothing$ 表示空条件,三项分别是:无条件估计、纯图像条件项(乘系数 $s_I$)、图像+文本条件项(乘系数 $s_T$)。论文设定 $s_I = 1.5$(保证与原图一致,不被改得面目全非)、$s_T = 7.0$(强化文本指令的服从性)。两个系数共同平衡“想要的变化”与“对原图的保真度”。
step 4. 潜特征拆分:去噪完成后得到 $64\times64\times5$ 的最终潜特征,按训练时的通道约定拆分:前 4 通道 = 合成后影像潜特征,后 1 通道 = 合成变化图($64\times64\times1$)。
step 5. 双路解码:
- 前 4 通道 → VAE Decoder 解码 → Syn. T2-Image ($H \times W \times 3$);
- 后 1 通道 → 插值上采样(Upsample) → Syn. Change Map ($H \times W$)。
2.2 RCDNet
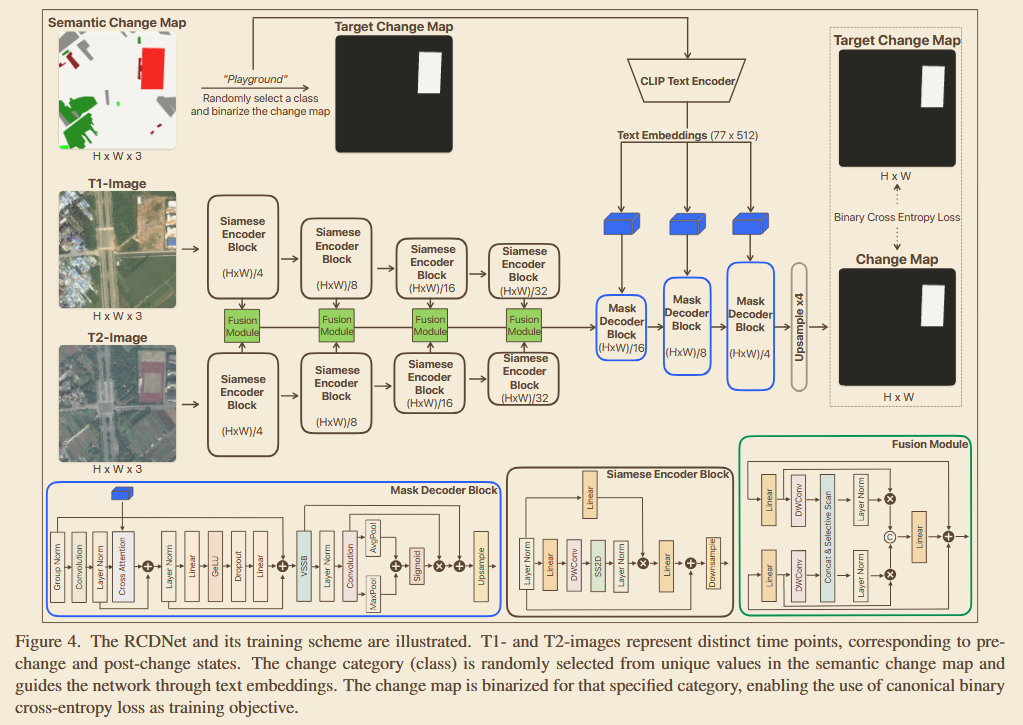
2.2.1 训练阶段
输入:
| 输入项 | 维度 | 说明 |
|---|---|---|
| T1-image | $H \times W \times 3$ | 变化前图像 |
| T2-image | $H \times W \times 3$ | 变化后图像 |
| Semantic Change Map | $H \times W$ | 用于随机选类并构造监督目标 |
| 类别名(文本) | 字符串 | 从语义变化图的唯一类别值中随机抽取 |
输出与损失
输出为该类别的预测变化图,与二值化目标之间计算二值交叉熵损失(Binary Cross Entropy Loss)——正因为训练时把语义变化图按选中类别二值化,才能使用这个最简单的损失,而不需要任何语义分割式的多类损失。
步骤如下:
step 1. 构造训练目标
随机选中一个类别(如“Playground”),将语义变化图按该类二值化 $\rightarrow$ Target Change Map($H \times W$),作为 BCE 的监督信号。
step 2. 文本编码
类别名 $\rightarrow$ CLIP Text Encoder $\rightarrow$ 文本嵌入($77 \times 512$)(77 为 CLIP 的 token 序列长度,512 为嵌入维度)。
step 3. 孪生编码(4 级,逐级减半分辨率、翻倍通道数)
T1 与 T2 分别进入共享权重的 Siamese Encoder Block(SEB,内部由 VMamba 的 VSSB + Layer Norm + Convolution + 下采样构成),两级并行地产生四级特征:
- 第 1 级:$(H \times W)/4$
- 第 2 级:$(H \times W)/8$
- 第 3 级:$(H \times W)/16$
- 第 4 级:$(H \times W)/32$
每一级的 T1 特征与 T2 特征分别送入对应分辨率的 Fusion Module(即 4 个 FM)。
step 4. 跨分支融合(Fusion Module,4 个)
每个 FM 内部结构(图2 绿框):Linear → DWConv(深度可分离卷积) → Concat & Selective Scan(CSS) → Layer Norm → Linear → Layer Norm → 输出单路融合特征。
CSS 的做法是:把两分支特征各自展平后沿序列长度维拼接,让 Mamba 的选择性扫描在同一个序列中同时“读”到 T1 和 T2 的特征,从而增强跨时相长程上下文敏感度——这是区别于纯卷积融合的关键设计。
step 5. 文本引导掩膜解码(3 个 Mask Decoder Block)
三级融合特征$(H \times W)/4$、$(H \times W)/8$、$(H \times W)/16$ 分别进入 MDB。每个 MDB 内部(图 2 蓝框)包含:
- 卷积前端:Group Norm → Convolution → Layer Norm
- 交叉注意力层:视觉特征作 query,CLIP 文本嵌入($77 \times 512$)作 key 和 value——“语言指路、视觉检索”在此实现
- FFN:Layer Norm → Linear → GeLU → Dropout → Linear → Layer Norm
- 局部增强:VSSB(Mamba 块)+ Layer Norm + Linear + DWConv
- 通道依赖增强:对特征通道同时做 AvgPool 和 MaxPool,池化结果融合后经 Sigmoid、Group Norm、Convolution、Layer Norm,并接一个小型 Fusion Module
- 每级 MDB 输出经 Upsample 逐级回接到更高分辨率,最终输出 $(H \times W)/4$ 的掩膜预测
step 6. 上采样与损失
$(H \times W)/4$ 的预测经 Upsample $\times 4$ 恢复到 $H \times W$,与 step 1 的 Target Change Map 计算 BCE 损失。
训练配置:AdamW,初始学习率 $6 \times 10^{-5}$,权重衰减 0.01,多项式衰减调度(指数 0.9),200 epochs,batch size 4,单张 NVIDIA RTX A6000(48GB)。
2.2.2 推理阶段
输入:
- T1-image,H×W×3,变化前图像
- T2-image,H×W×3,变化后图像
- 用户文本(如 “Water Body”),字符串,用户想看的变化类别,取代训练时的“随机选类”
输出:仅包含用户指定类别变化的二值变化图 ($H \times W$) ——这是 RCD 任务的定义式输出,对应任务定义 $M = f(I_{pre}, I_{post}, C)$
步骤如下:
step 1. 常规前向:T1、T2 编码 $\rightarrow$ 4 级 FM 融合 $\rightarrow$ 用户文本经 CLIP 编码为 $77 \times 512$ 嵌入 $\rightarrow$ 3 级 MDB 解码 $\rightarrow$ 上采样 $\times 4$ $\rightarrow$ 该类别的二值变化图 ($H \times W$)。流程与训练完全一致,唯一区别是文本由用户意图给出而非从标签中随机抽取。
3. 实验细节
使用的数据集
- SECOND
- CNAM-CD
- LEVIR-CD / LEVIR-CD+
- WHU-CD
1-2 为语义变化检测(SCD)基准数据集,用于同域 SCD 与混合数据集实验,二者类别定义互不一致(正是 RCD 要解决的问题背景);SECOND 中 “playground” 仅 129 图、$0.38%$ 面积占比,CNAM-CD 中 “water bodies” 仅 394 图——类别严重不均衡。
3(LEVIR-CD/LEVIR-CD+)与 4(WHU-CD)为二值建筑变化检测(BCD)数据集,单类别(建筑物),用于同域 BCD 实验;同时在跨域实验中作为测试集(训练在 SECOND 上进行)。LEVIR-CD/LEVIR-CD+ 还参与 RCDGen 合成数据的训练。
训练与实现细节
- RCDNet 训练:AdamW 优化器;初始学习率 $6 \times 10^{-5}$,权重衰减 0.01;学习率多项式衰减(指数 0.9);200 epochs,batch size = 4;单卡 NVIDIA RTX A6000(48GB 显存)
- RCDGen(合成管线)训练:基于 Hugging Face Diffusers 库,从预训练 InstructPix2Pix checkpoint 出发微调 Stable Diffusion 15,000 个 iteration,batch size = 4
- 合成采样参数:双条件 guidance 系数 $s_I = 1.5$(图像一致性)、$s_T = 7.0$(文本服从性)
- 文本编码器:CLIP(消融验证 OpenAI CLIP 优于遥感专用 RemoteCLIP);编码器骨干最终选定 VMamba-small;解码器选定 Mamba 版(优于 MLP 版)
- 预训练策略:先用 55,300 张合成样本(29,500 SECOND 来源 + 17,500 CNAM-CD 来源 + 8,300 inpainting)预训练,再在目标数据集精调;消融对比了合成数据 / ImageNet / 从零初始化三种起点,合成数据预训练起点与最终性能均最优
使用的实验设置
论文围绕 RCDNet 展开了四组对比实验 + 一组消融研究,实验设置划分如下:
实验 1:同域 SCD(Within-domain)
在 SECOND 和 CNAM-CD 上训练并测试(同数据集内划分训练/测试集),与 SCD 方法对比。为保证与 SCD 公平比较,使用类别名作为文本提示,对每个类别分别前向得到二值图后聚合成统一语义变化图,且聚焦 post-change(增长型)变化。
实验 2:同域 BCD(Within-domain)
在 LEVIR-CD 和 WHU-CD(单类建筑变化数据集)上训练并测试,直接以 “building” 为文本提示输出变化图,与 BCD 方法对比。
实验 3:跨域(Cross-domain)
在 SECOND 上训练(因其包含 buildings 子类),在 WHU-CD 和 LEVIR-CD 上测试,考察跨数据集泛化能力——这是本文优势最突出的场景。
实验 4:混合数据集(Mixed Dataset)
将 SECOND 与 CNAM-CD 合并为一个训练集训练单一模型,再分别在各自测试集上评估,验证 RCD 打破“类别定义对齐才能混训”限制的能力。
实验 5:零样本(Zero-shot,附加实验)
目标变化类别在训练中从未出现过。作者结论谨慎:部分结果有前景,但跨图像、跨类别表现不稳定,不做强声明。
消融实验(Ablation Studies)
在 SECOND 验证集上,使用综合指标 $0.3 \times mIoU + 0.7 \times SeK$进行评分。
4. 与前一篇相比,核心变化是什么?
本文所使用的模型,与以往的模型功能有很明显的区别,正如本文的模型RCD,他可以根据用户所需要的类别进行变化检测,而以往的模型要么是直接预测变化、预测出来之后进行多次对话问答(并没有实现可以按类别划分)等。
OpenDPR
论文名称:OpenDPR: Open-Vocabulary Change Detection via Vision-Centric Diffusion-Guided Prototype Retrieval for Remote Sensing Imagery
阅读日期:2026.11.14
所属方向与编号:视觉语言驱动的变化检测-08
预知识:
- 视觉基础模型(VFM), 模型类别 , 在海量图像上预训练、能提取高质量视觉表征的通用模型,本文用到 SAM(能根据提示分割“任何东西”)、DINOv2(自监督学习、空间结构化的视觉表征)。这些模型不需要针对变化检测任务做训练,天然具有强泛化能力。
- 视觉语言模型(VLM), 模型类别,通过大规模“图像-文本对”联合训练,把视觉语义和语言语义对齐到同一空间的模型,代表是 CLIP。它的好处是支持“开放词汇”的零样本识别——你输入文字“建筑”,它就能在图像中找到对应区域,这正是现有 OVCD 方法识别变化类别的手段。
- 免训练(Training-Free),方法设定,不需要在自己任务的数据上做任何训练,直接组合现成模型完成推理,优点是无需标注、成本低;缺点是性能上限受制于各基础模型本身。
- LLM(大语言模型),模型类别,能理解并生成自然语言文本的大规模语言模型
- 扩散模型,生成模型类别,通过逐步“去噪”过程从文本生成逼真图像的生成式模型
1. 这篇论文要解决什么问题?
传统遥感变化检测(包括二元变化检测 BCD 和语义变化检测 SCD)都建立在“封闭世界假设”上——模型只能识别训练时预先定义的固定类别。但真实遥感场景中地物类型极其多样、标注数据稀缺,这种假设严重限制了实际应用。为此,开放词汇变化检测(OVCD)被提出,现有方法(如 DynamicEarth 的 M-C-I 框架)通常用视觉基础模型(SAM、DINOv2)生成变化提案,再用视觉语言模型(CLIP)通过“图-文匹配”识别变化类别。
这篇论文要解决开放词汇变化检测(OVCD)中“CLIP 图-文匹配范式无法准确识别细粒度地物变化类别(主瓶颈)”和“视觉基础模型缺乏变化先验导致变化定位不准(次瓶颈)”两大问题。
作者通过 Oracle 对照实验诊断出 OVCD 的两大瓶颈。主要瓶颈是类别识别错误——CLIP 类模型存在遥感域差距,文本特征只能表达高度浓缩的全局语义,无法准确表征细粒度地物类别(真值提案+模型识别仅 23.8% mIoU);次级瓶颈是变化定位不准——SAM/DINOv2 缺乏双时相变化先验,产生大量误检(最终完整流程 mIoU 降至 13.1%)。论文针对这两个瓶颈,分别提出:
①免训练的视觉中心框架 OpenDPR——用 LLM 提示扩散模型离线构建类别视觉原型,推理时在纯视觉空间做相似度检索,绕开失效的图-文匹配范式;
②弱监督变化定位模块 S2C——仅需图像级标签,用 VFM 空间先验矫正 CAM 伪标签,二者结合形成更强变体 OpenDPR-W。
2. 输入和输出分别是什么?
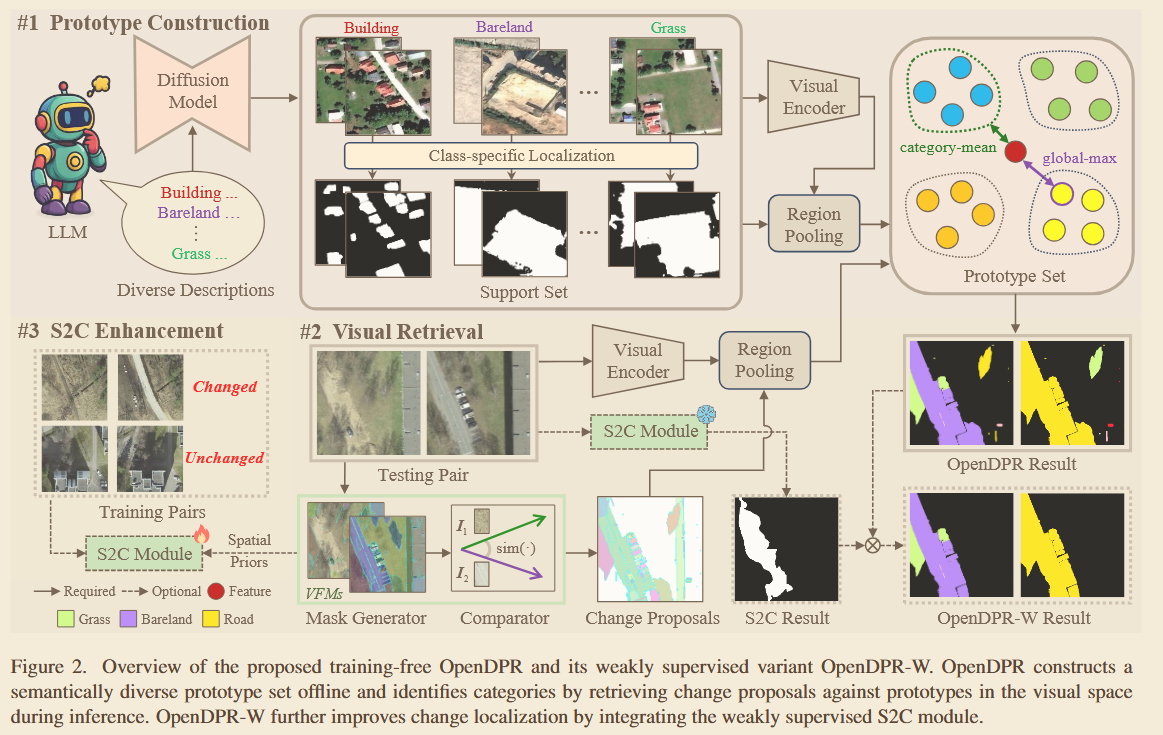
2.1 OpenDPR(免训练框架)
2.1.1 离线原型构建
对应 Figure 2 中的 #1 Prototype Construction
输入: 目标地物类别名 $c \in C$(如 Building、Bareland、Grass)+ 大致地理位置(location)
step1.(LLM 生成描述)
- 将类别名和地理位置填入提示模板:“Generate $N_1$ diverse and detailed descriptions of [c] in remote sensing imagery. Each description should begin with ‘a satellite image of [c] in [location]’ and describe its appearance, texture, and surrounding context”,交给 GPT-4
- 输入=提示文本
- 输出=每个类别 $N_1=20$ 条多样化文本描述(对应 Figure 2 左侧机器人口中的“Diverse Descriptions”,即 Building…/Bareland…/Grass… 那一列)
step2.(扩散模型合成图像)
每条描述输入遥感扩散模型 DiffusionSat,每条生成 (M=5) 张合成图像
输出=类别 (c) 的支持集 $\mathcal{J}_c = {I_{c,i}}$,共 $N_1 \times N_2$ 张合成卫星图(对应 Figure 2 上排三组彩色小图:Building、Bareland、Grass 各一摞)
step3.(类别定位)
- 每张合成图连同类名 (c) 送入 APE 模型
- 输出=像素级类别掩码 $M_{c,i}$,构成配对支持集 $S_c = (\mathcal{J}_c, \mathcal{M}_c)$(对应 Figure 2 中“Class-specific Localization”模块及其下方黑白掩码图,合成图+掩码即图中标注的“Support Set”)
step4.(特征提取与掩码池化)
用 DINOv2 提取每张合成图的特征图 $F_{c,i} \in \mathbb{R}^{H/p \times W/p \times d}$(H、W 为原图高宽,d 为特征维度,p 为特征提取器的 patch 大小),上采样回原分辨率后做掩码平均池化:
$$
z_{c,i} = \frac{\sum_{h=0}^{H} \sum_{w=0}^{W} M_{c,i}(h, w) F_{c,i}(h, w)}{\sum_{h=0}^{H} \sum_{w=0}^{W} M_{c,i}(h, w)} \quad \tag{1}
$$
其中 (h,w) 为空间坐标。输出=区域级特征集合 $\mathcal{Z}_c = {z_{c,i}}$(对应 Figure 2 中“Visual Encoder”+“Region Pooling”两个模块)
step5.(聚类生成原型)
对 $\mathcal{Z}_c$ 做 K-means 聚类:
$$
\mathcal{P}_c = \{p_{c,k}\}_{k=1}^K = \text{KMeans}(\mathcal{Z}_c, K) \quad \tag{2}
$$
K 在 SECOND 设 10、其余数据集设 5。输出=该类别原型集 $\mathcal{P}_c$,所有类别合并为原型库 $\mathcal{P} = {\mathcal{P}_1, …, \mathcal{P}_C}$(对应 Figure 2 右侧散点图“Prototype Set”,图中绿色点示意 category-mean 聚类中心、红色点示意 global-max)
2.1.2 在线推理
对应 Figure 2 中的 #2 Visual Retrieval
step1.(SAM 生成掩码)
$I_1$、$I_2$ 分别送入 SAM,输出=两期初始实例掩码集合 $\mathcal{M}_1$、$\mathcal{M}_2$(对应 Figure 2 中”Mask Generator”模块,图内标注”VFMs”即指 SAM)。
step2.(NMS 去冗余)
对两期掩码并集做非极大值抑制。输出=最终地物实例掩码:
$$
\mathcal{M} = \text{NMS}(\mathcal{M}_1 \cup \mathcal{M}_2)
$$
去除重复掩码和未变化物体的冗余检测。
step3.(双时相掩码池化特征)
DINOv2 分别提取两期特征图,插值到掩码分辨率,按公式 1 同样的掩码平均池化在每个实例掩码内聚合。
输出=掩码特征集合 $\mathcal{Z}_t = {(z_1^m, z_2^m)}_{m=1}^{|\mathcal{M}|}$,每个掩码对应一对双时相特征(对应 Figure 2 中”Visual Encoder”+”Region Pooling”通路)。
step4.(比较器判断变化)
对每个掩码的双时相特征对计算负余弦相似度作为变化分数,分数超过阈值 $\alpha$(沿用 DynamicEarth 的设定)的掩码保留:
$$
\text{score} \propto -\frac{z_1 \cdot z_2}{|z_1|_2 |z_2|_2}, \quad \text{score} > \alpha \Rightarrow \text{保留为变化提案}
$$
这个式子 = 余弦相似度(衡量两期特征方向的一致性)+ 负号(把“相似度”翻转成“变化度”)+ 正比符号(因为原文只定性说明分数与负余弦相似度成正比,未给出精确归一化形式)。
输出= 类无关变化提案集合 $\mathbf{M}$(对应 Figure 2 中”Comparator”$\rightarrow$”Change Proposals”通路,图中 $\text{sim}(\cdot)$ 与 $l_1 \rightarrow L_1$、$l_2 \rightarrow L_2$ 连线即示意此计算)。
step5.(视觉原型检索识别类别)
对每个提案特征 $z_i$ 与原型 $p_{c,k}$ 计算余弦相似度:
$$
\text{sim}(z_i, p_{c,k}) = \frac{z_i \cdot p_{c,k}}{||z_i||_2·||p_{c,k}||_2}\quad \tag{3} i \in \{1, 2\}
$$
再按两种策略之一分配类别——category-mean:取类别内 K 个原型平均相似度最高的类:
$$
\hat{c}_i = \arg \max_c \frac{1}{K} \sum_{k=1}^K \text{sim}(z_i, p_{c,k}) \quad \tag{4}
$$
global-max:取全类别所有原型中单一最高相似度者所属类:
$$
\hat{c}_i = \arg \max_{c,k} \text{sim}(z_i, p_{c,k}) \quad \tag{5}
$$
消融 Table 5 显示 global-max 普遍更优(如 LEVIR-CD 上 44.83 vs 36.65),因其避免特征平均的稀释。
输出= 每个变化提案的类别标签 $\hat{c}_i$。
最终输出:每个变化区域的掩码 + 开放词汇类别标签,即完整 OVCD 预测(对应 Figure 2 右上角”OpenDPR Result”彩色分割图,图中为 Grass/Bareland/Road 三类着色)
2.2 OpenDPR-W
2.2.1 S2C 预训练
OpenDPR-W 的训练阶段
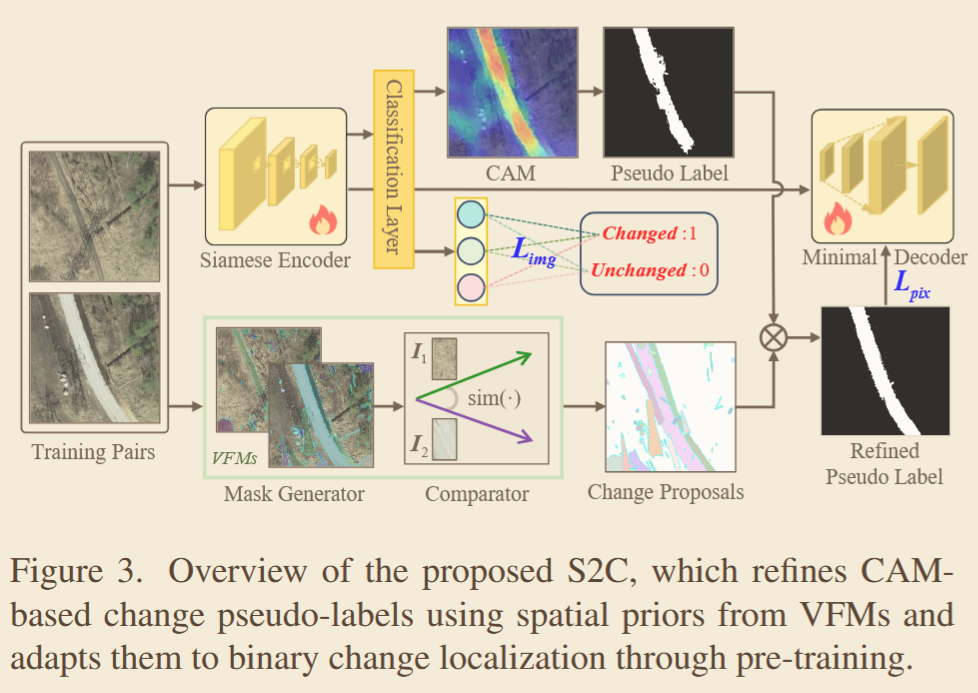
输入:
- 训练集双时相图像对 $L_t = {I_1, I_2} \in \mathcal{D}_{train}$ (对应 Figure 3 左下角”Training Pairs”)
- 图像级变化标签 $Y_{cls} \in {0, 1}$ (对应 Figure 3 中”Classification Layer”旁”Changed :1 / Unchanged :0”标注。无需像素级标注)
step1.(孪生编码器提特征)
两期图像送入共享权重孪生编码器(MiT-b1,分层结构更适合分割)
输出=末层特征图 $F_1$、$F_2$ (对应 Figure 3 左侧”Siamese Encoder”两个黄色塔状模块)
step2.(图像级分支)
逐元素绝对差融合变化特征 $F_f = |F_1 - F_2|$,经全局平均池化 + $1\times1$ 卷积得图像级预测 logit $p_{img}$,计算图像级二元交叉熵损失:
$$
\mathcal{L}_{img} = \ell_{bce}(Y_{cls}, p_{img})
$$
(对应 Figure 3 中”Classification Layer”通路与 $L_{img}$ 标注)
step3.(CAM 生成粗伪标签)
用分类器权重 $W_{cls}$ 对 $F_f$ 做类特定加权求和得 CAM (类激活图),min-max 归一化后按阈值 $\beta=0.5$ 二值化。
输出= 粗像素级伪标签 $\hat{Y}_{pix}$ (对应 Figure 3 上方”CAM”$\rightarrow$”Pseudo Label”通路,图中白色形状即粗伪标签)。
step4.(VFM 空间先验精炼伪标签——S2C 的核心创新)
按 OpenDPR 同款流程(SAM+DINOv2,对应 Figure 3 下方”VFMs $\rightarrow$ Mask Generator $\rightarrow$ Comparator $\rightarrow$ Change Proposals”通路)从训练图像对提取类无关变化提案 $\mathbf{M}$;对每个提案 $M_i$ 计算与粗伪标签的重叠率:
$$
r_i = \frac{|M_i \cap \hat{Y}_{pix}|}{|M_i|}\quad\quad \text{$|\cdot|$ 为像素计数} \tag{7}
$$
满足 $r_i > \gamma_1$ ($\gamma_1=0.05$)的提案融合。
输出= 边界更精准的精炼伪标签 $\hat{Y}_{pix}^{ref}$ (对应 Figure 3 中 Change Proposals $\rightarrow$ $\otimes$ $\rightarrow$ “Refined Pseudo Label”通路)。
step5.(像素级分支与总损失)
$F_f$ 送入轻量分割头(MLP + dropout + 两个 $1\times1$ 卷积,对应 Figure 3 右侧”Minimal Decoder”)
输出=像素级预测 $p_{pix}$,计算:
$$
\mathcal{L}_{pix} = \ell_{bce}(\hat{Y}_{pix}^{ref}, p_{pix})
$$
S2C 预训练总损失:
$$
\mathcal{L} = \mathcal{L}_{img} + \lambda \mathcal{L}_{pix} \quad\quad \lambda = 1 \tag{6}
$$
训练 10,000 次迭代、batch size 8、输入 resize 至 $256\times256$,按验证集最佳 F1 保存模型。
训练输出:具备二值变化定位能力的 S2C 模块权重(对应 Figure 2 下方”#3 S2C Enhancement”中”S2C Module $\rightarrow$ Spatial Priors”通路,可训练参数仅 13.4M)。
2.2.2 OpenDPR-W 推理阶段
输入:测试集双时相图像对 $I_t = {I_1, I_2} \in \mathcal{D}_{test}$
step1.(S2C 预测变化区域)
用预训练好的 S2C 对测试图像对做二值预测。
输出=二值变化区域 $\mathcal{R}$(对应 Figure 2 中”S2C Module”$\rightarrow$”S2C Result”黑白掩码)
step2.(OpenDPR 免训练流程并行执行)
完整执行第一部分阶段 B 的 step1-step5(SAM 掩码生成 $\rightarrow$ NMS $\rightarrow$ DINOv2 掩码池化 $\rightarrow$ 负余弦相似度比较与阈值 $\alpha$ 筛选 $\rightarrow$ 原型检索)
输出=类无关变化提案 $\mathbf{M}$ 及视觉检索类别(对应 Figure 2 中”Change Proposals”及其右侧彩色概率图)
step3.(提案与变化区域融合)
对每个提案 $M_i$ 按与公式 7 相同的重叠率形式计算与 $\mathcal{R}$ 的重叠率:
$$
r_i = \frac{|M_i \cap \mathcal{R}|}{|M_i|}
$$
($|\cdot|$ 为像素计数)
保留 $r_i > \gamma_2$($\gamma_2=0.05$)的提案并聚合。输出=融合后的最终结果(对应 Figure 2 中”S2C Result”与”OpenDPR Result”之间的 $\otimes$ 融合符号,指向”OpenDPR-W Result”彩色分割图)。
最终输出:经弱监督定位增强的开放词汇变化检测图(掩码+类别标签)
3. 整体流程是什么?各模块分别做什么?
整体流程
1 | |
离线原型构建模块(#1 Prototype Construction)
为每个目标类别建立一组“视觉模板”,供推理时检索
- LLM(GPT-4),把一个干巴巴的类别名扩写成丰富的描述
- 扩散模型(DiffusionSat),把文字描述变成逼真的卫星图像
- APE(定位器),在合成图里框出目标类别所在像素
- DINOv2(特征提取器),把图像区域变成向量
- K-means 聚类,把同类特征压缩成少数几个“原型”
CLIP 的文本特征表达不了细粒度地物语义。OpenDPR 用“合成图像的真实视觉特征”替代文本特征,绕开了图-文匹配范式。
在线推理模块(#2 Visual Retrieval)
对一对前后时相影像,找出“哪里变了”+“变成了什么”
变化定位(Mask Generator + Comparator)
- SAM(掩码生成器 Mask Generator),在两期影像上切出所有地物实例
- NMS(非极大值抑制),清洗掩码集合
- DINOv2 + 掩码池化,给每个掩码配一双“前后时相特征”
- Comparator(比较器),判断“变没变”
类别识别(Identifier,OpenDPR 的核心创新点)
- 视觉原型检索,判断“变成什么”
M-C-I 用 CLIP 文本特征做识别(图-文匹配),OpenDPR 用视觉原型做识别(图-图匹配),完全在视觉空间内完成,无文本参与
弱监督增强模块(#3 S2C Enhancement,OpenDPR-W 专属)
解决次级瓶颈——VFM 缺乏变化先验导致的误检
训练阶段
- 孪生编码器(MiT-b1),提取两期图像的层级特征
- 变化特征融合,构造“变化感知”的特征
- 图像级分类分支,用图像级标签学全局判断
- CAM, 从分类分支“免费”抠出粗定位
- VFM 精炼(核心创新),用 SAM+DINOv2 的空间先验修正粗糙的 CAM
- 最小解码器,学像素级定位
- 总损失, 联合训练
推理阶段
- S2C,对测试影像对预测二值变化区域 ℛ
- 重叠率过滤,OpenDPR 的每个提案 $M_i$ 算与 ℛ 的重叠率(公式 7),保留 $r_i > γ₂=0.05$ 的提案 → 抑制误检
4. 与前一篇相比,核心变化是什么?
把“开放变化检测”从“语言在推理时在环的跨模态融合网络(需要用扩散合成数据训练)”改造为“语言只用于离线造图、推理全程在纯视觉空间完成的免训练原型检索框架”
RCD 没关心“找变化找得准不准”这个问题,OpenDPR 通过实验发现这是第二个短板(SAM、DINOv2 天生不懂“前后对比”)。于是它加了个补救模块 S2C:只用“这图有没有变化”这种最偷懒的标注(图像级标签,不用画像素级掩码)稍微训练一下,误检就大幅减少。这是前一篇完全没有的维度。
碎碎念
碎碎念
碎碎念
它的设计哲学是把“开放”落实在“加类别零成本”而非“无限类别现场识别”
经过一系列的疑问解答,最后本文的模型的优点如下:它的真正卖点从来不是“什么都能认”,而是这四条:
- 零训练、零像素标注——现成基础模型拼装 + 一次离线生成,这是它和 RCD(需要训练网络)最本质的分界线;
- 推理在纯视觉空间完成——用实验证明了文字提示这条路是瓶颈,然后把文字彻底请出推理环节,换来实打实的精度提升;
- 多类一次出图——不用像 RCD 那样一类一问一跑;
- 加类别的边际成本接近零——虽然不是无限类,但扩展不训练、原型库可复用、定位环节类无关(新类“找得到只是叫错名”)。
RCD OpenDPR 理论上 文字随便写,看似无限类 类别集合 = 原型库,有边界 实际上 训练数据没覆盖的类,输入提示也认不准 库内每类都认得准;库外先补几分钟原型 加新类成本 重新生成数据 + 重新训练 纯前向推理,零训练
如果想要的类别没有,想加进去的话,本模型如下:
正因为原型库不依赖真实数据,加新类别才那么容易:想加“太阳能板”?不需要收集太阳能板的真实遥感数据集,只需要:
- 告诉 LLM “describe solar panels in satellite imagery”
- 扩散模型画出 100 张太阳能板假图
- 提特征、聚类,塞进原型库
不是“把所有数据里的类别拆出来存好,新图来查库”;
而是“拿着一张类别名单,让 AI 凭想象给每个类别画出标准照、存成视觉原型;新图来了切块提特征,先判断变没变,变了就去这套‘想象图鉴’里认亲戚”——图鉴是造出来的,不是挖出来的,所以它才免训练、可随加随用。